Natural Language UnderstandingNeural Pretrained Language Modeling
Natural Language
Understanding
Neural Pretrained
Language Modeling
Understanding
Neural Pretrained
Language Modeling
Mingming Sun
BIMSA
Outline
Outline
ELMO: When Language Model Meets Word Embedding
GPT: Language Model + Transformer
BERT: Masked Language Model + Transformer
T5: Pretrained Encoder-Decoder Transformer
Pretrained Language Models Gallery
2.3 Pretrained Language Models 2.3.1 Language Models and Word Embeddings
2.3 Pretrained Language Models 2.3.1 Language Models and Word Embeddings
Recall: Word Embedding
Recall: Word Embedding
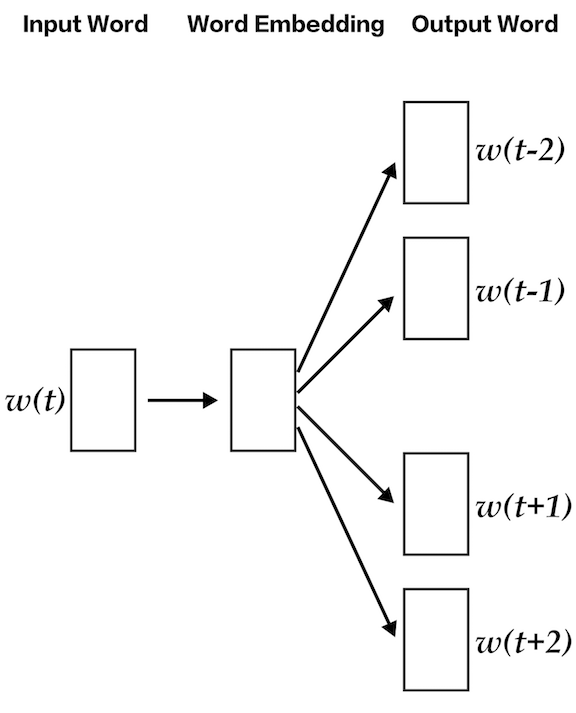
Word2Vec: Predict occurrence of neighborhood;
GloVe: Approximate the co-occurrence information:
Each word has an embedding vector;
Representing the meaning learned from the global environment.
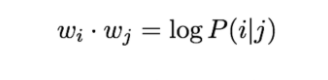
Recall: Word Embedding
Recall: Word Embedding
Global Environment:
Language is bag of words.
Co-occurrence is the statistical connection.
Polysemy words need local environment.
Apple (fruit/company)
打(打游戏/打人/打酱油)
More thorough modeling of language?
Recall: Probabilistic Language Model
Recall: Probabilistic Language Model
The more thorough language modeling over Bag of Words?
Probabilistic Language Model:
Maximize the likelihood of language by optimizing the word embedding!
How to do that?
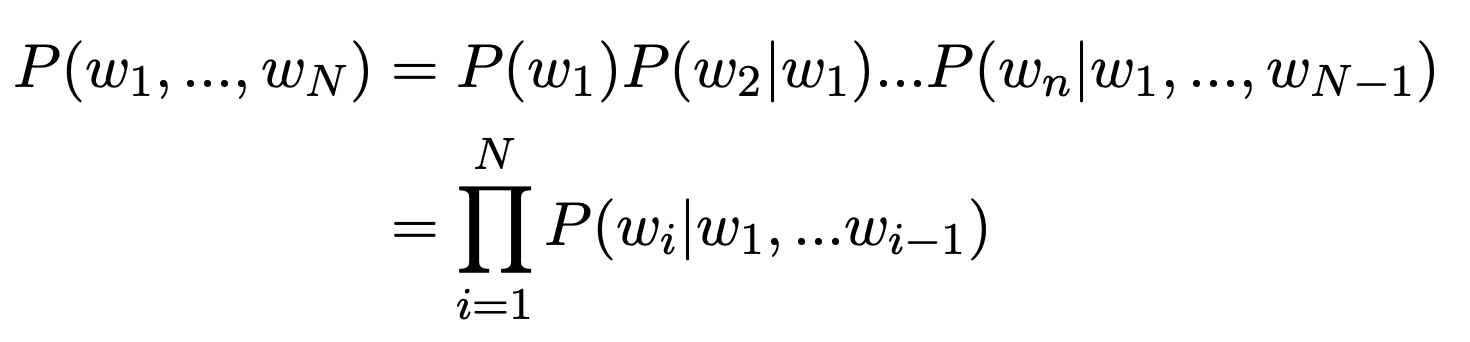
Recall: Sequence to Sequence RNN
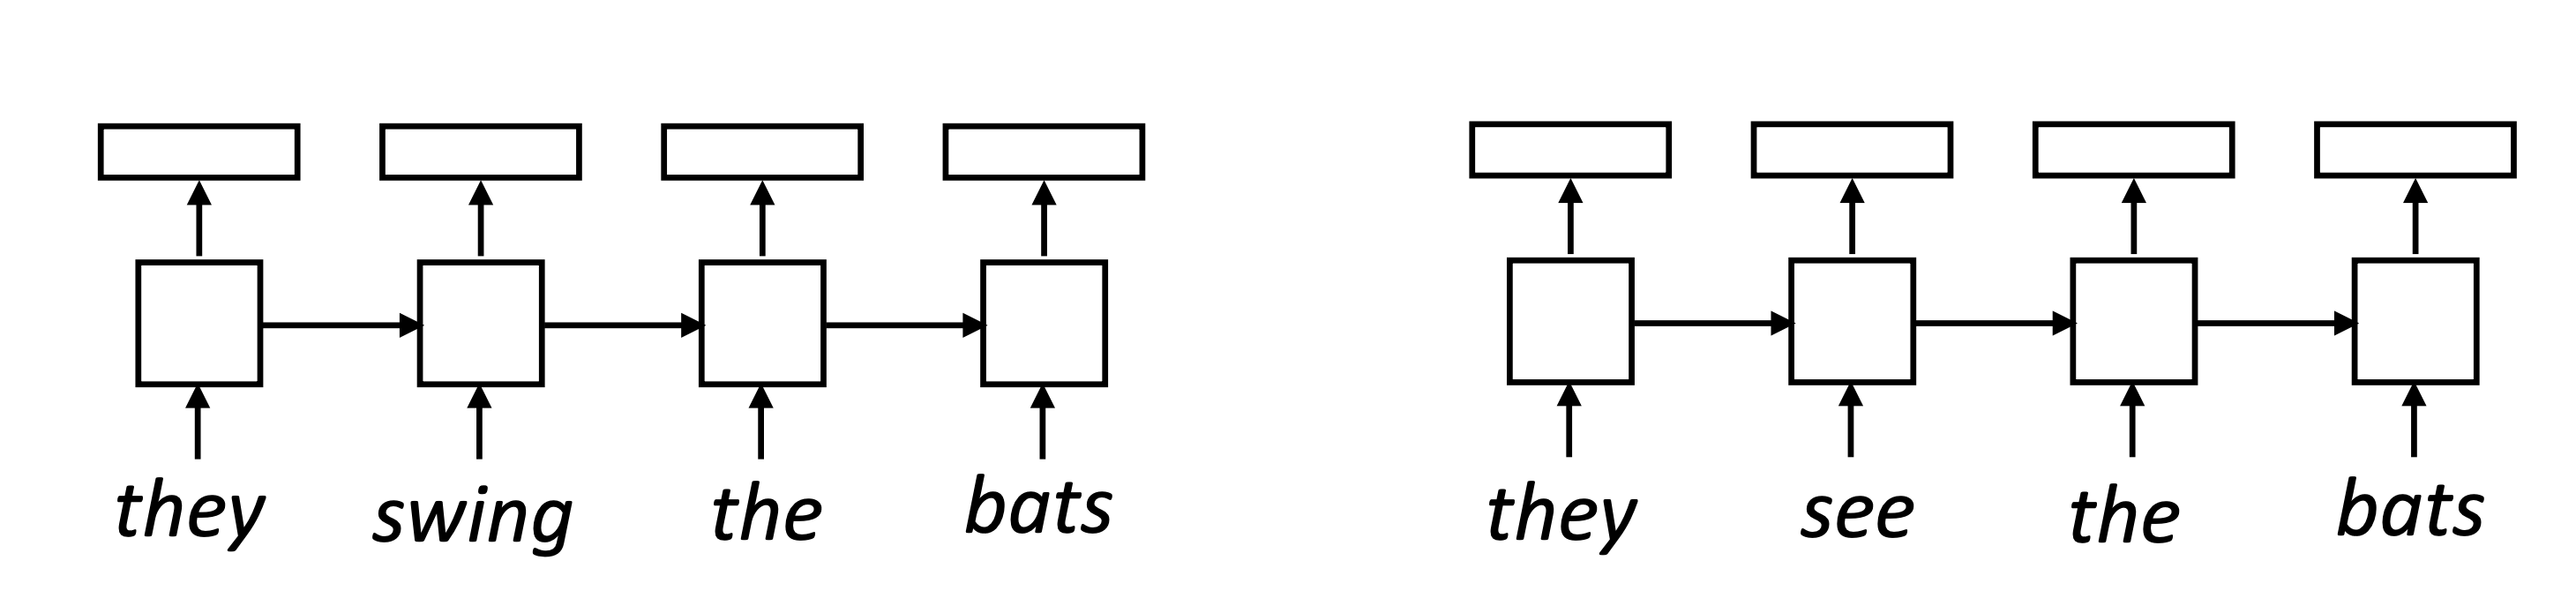
Recall: Sequence to Sequence RNN
Sequence to Sequence RNN (e.g. LSTM or Transformer) is proposed to perform sequence transform (e.g. From French to English);
It maps each word/token into a local embedding (dependent on its neighborhood /history words);
But this embedding is task dependent, not for the accurate meaning representation in language, so not usable for other tasks.
We need to focus on language itself, not specific tasks.
Learning Context-dependent Meaning Embeddings
Learning Context-dependent Meaning Embeddings
https://www.cs.utexas.edu/~gdurrett/courses/fa2022/lectures/lec20-1pp.pdf
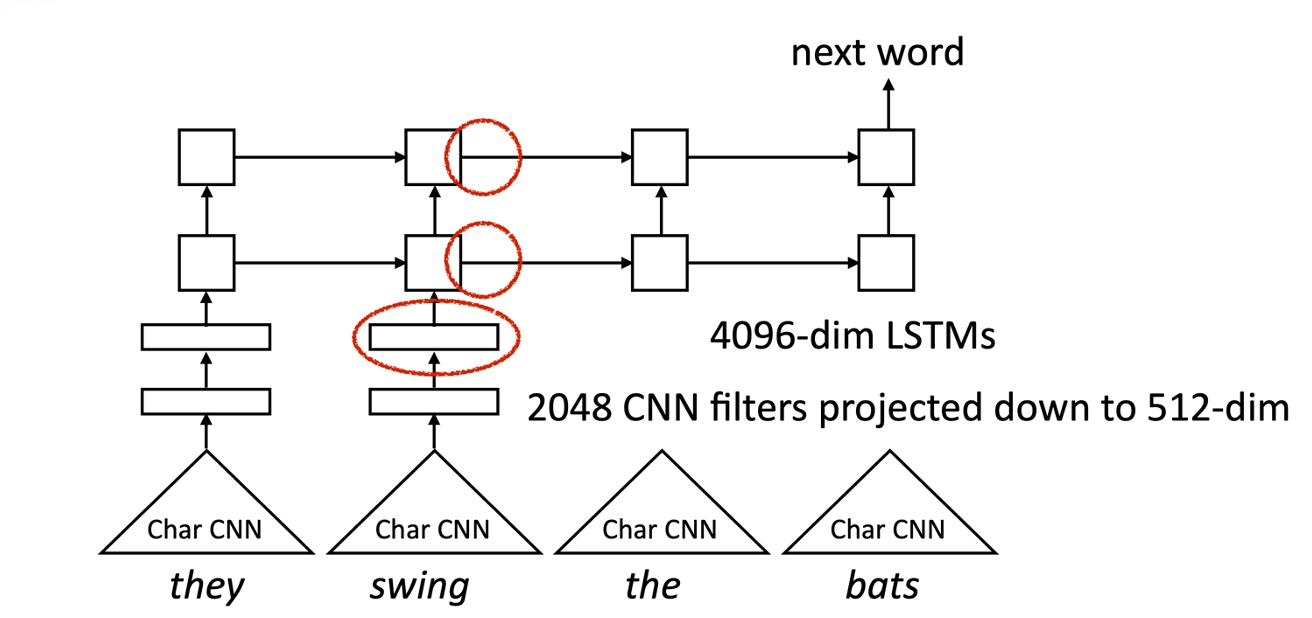
ELMO: Embeddings from Language Models (AllenAI, 2018)
ELMO: Embeddings from Language Models
(AllenAI, 2018)
(AllenAI, 2018)
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture06-fancy-rnn.pdf
ELMO - Training
ELMO - Training
https://jalammar.github.io/illustrated-bert/
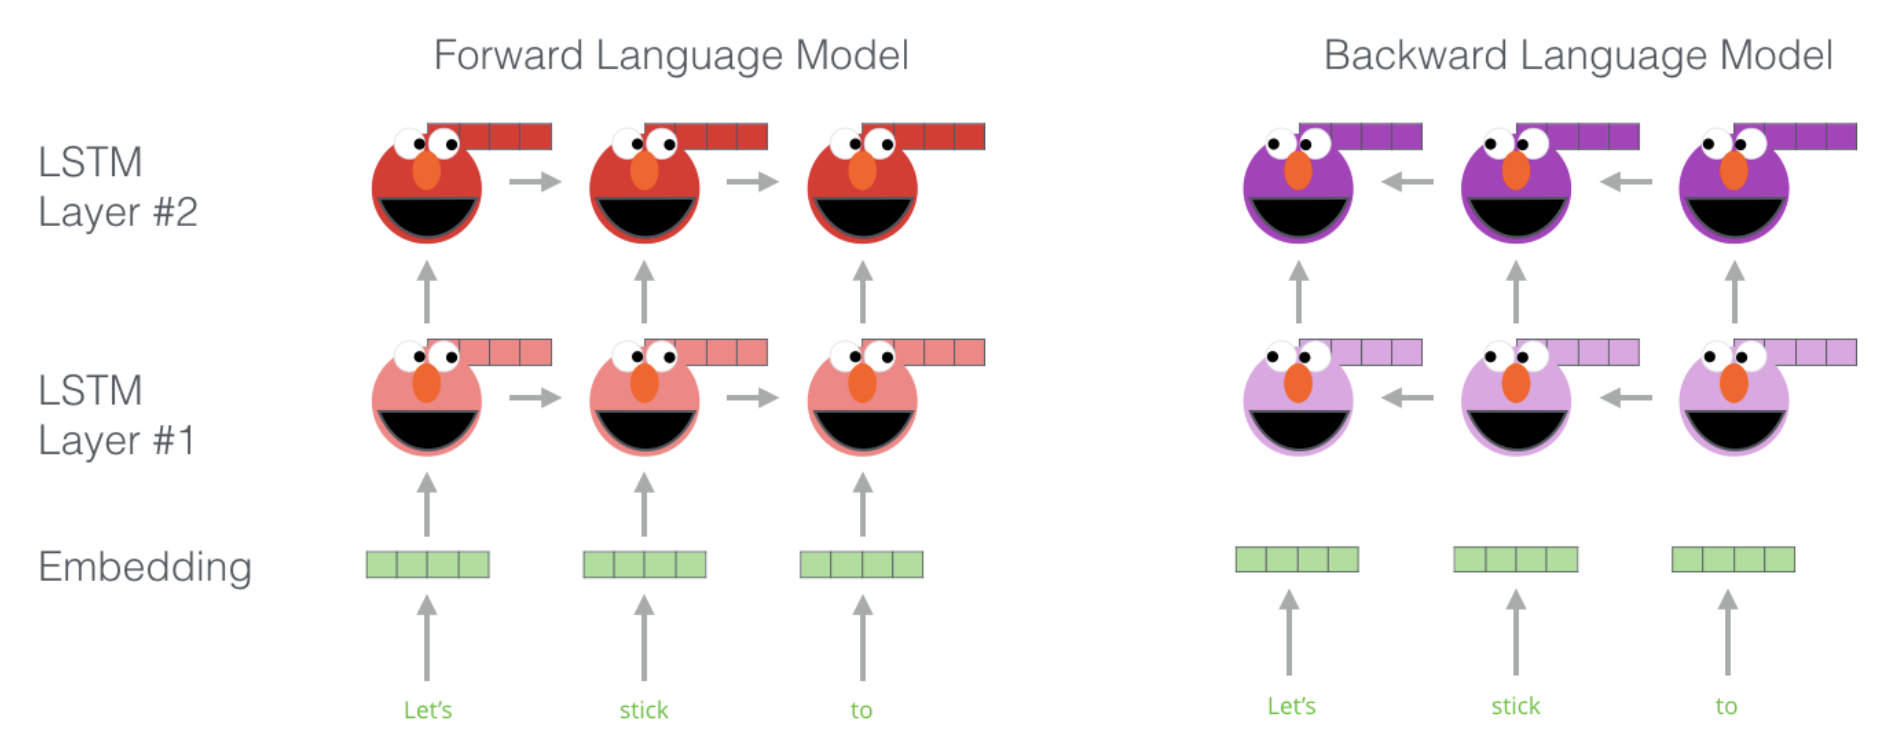
Training for 10 epochs on the 1B Word Benchmark
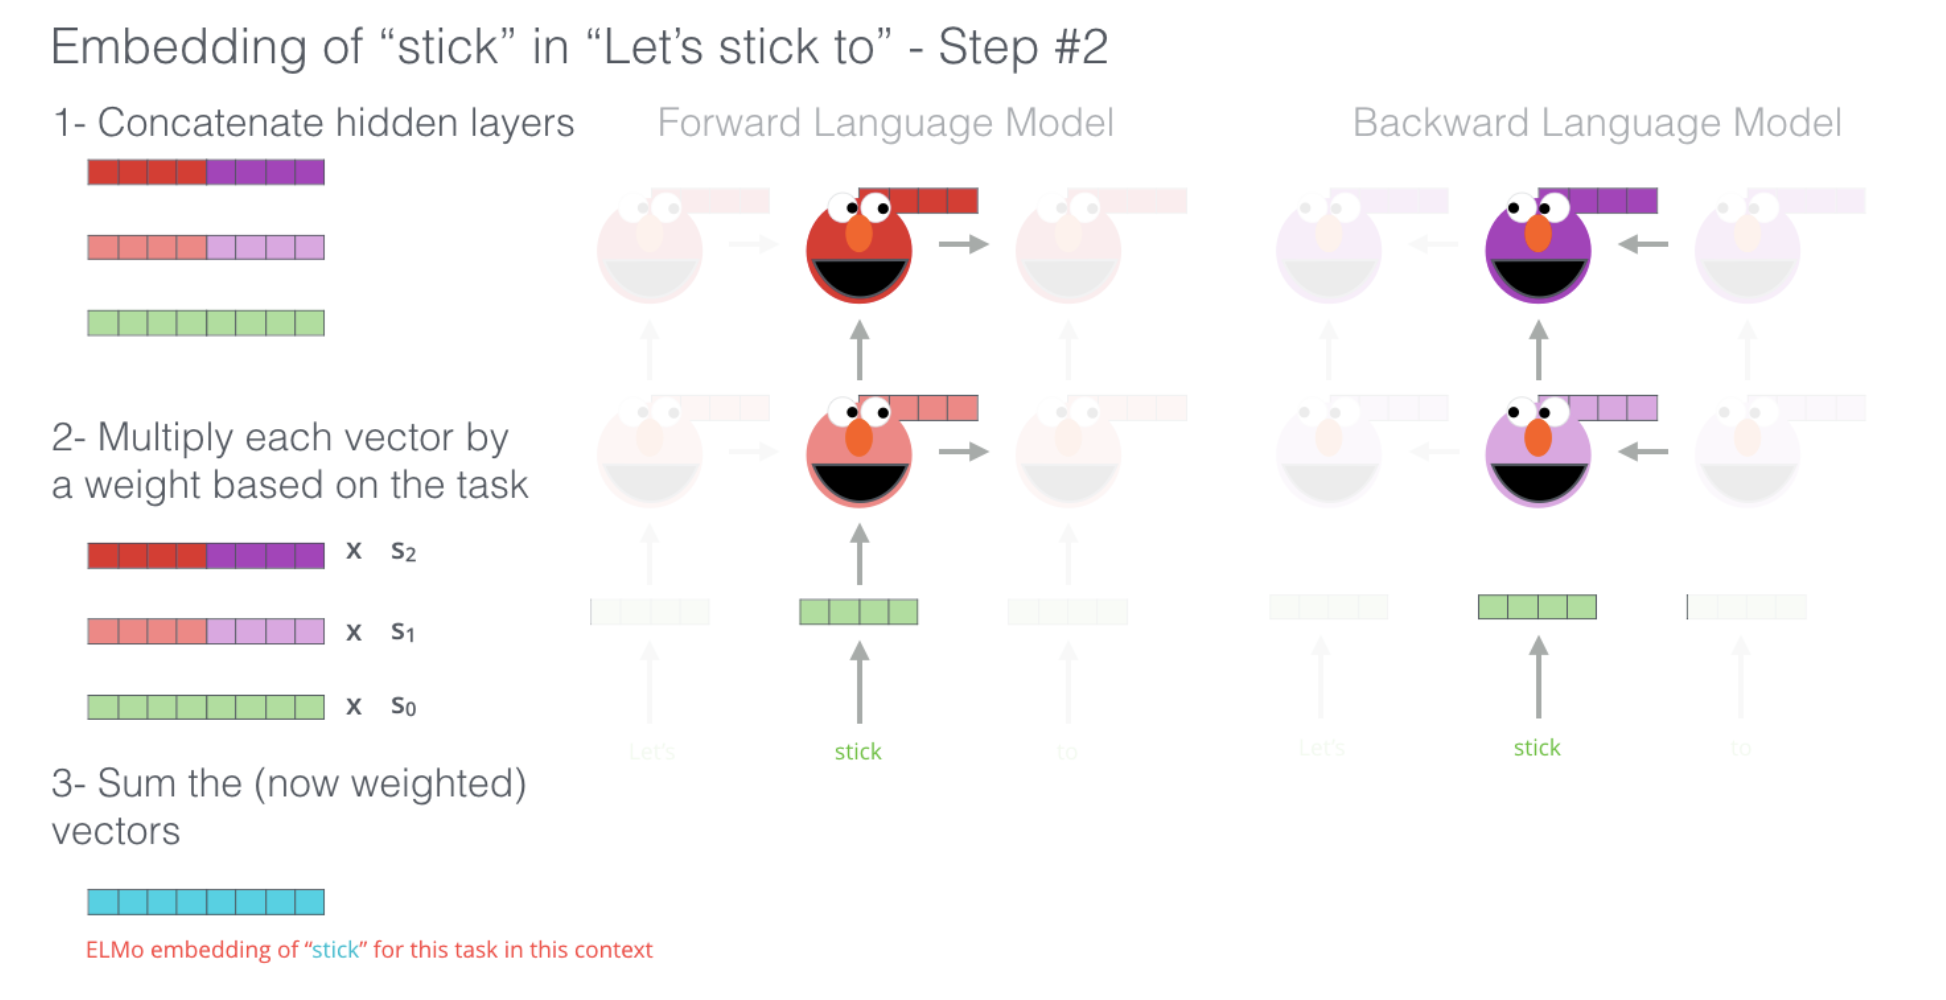
ELMO – Embedding
ELMO – Embedding
https://jalammar.github.io/illustrated-bert/
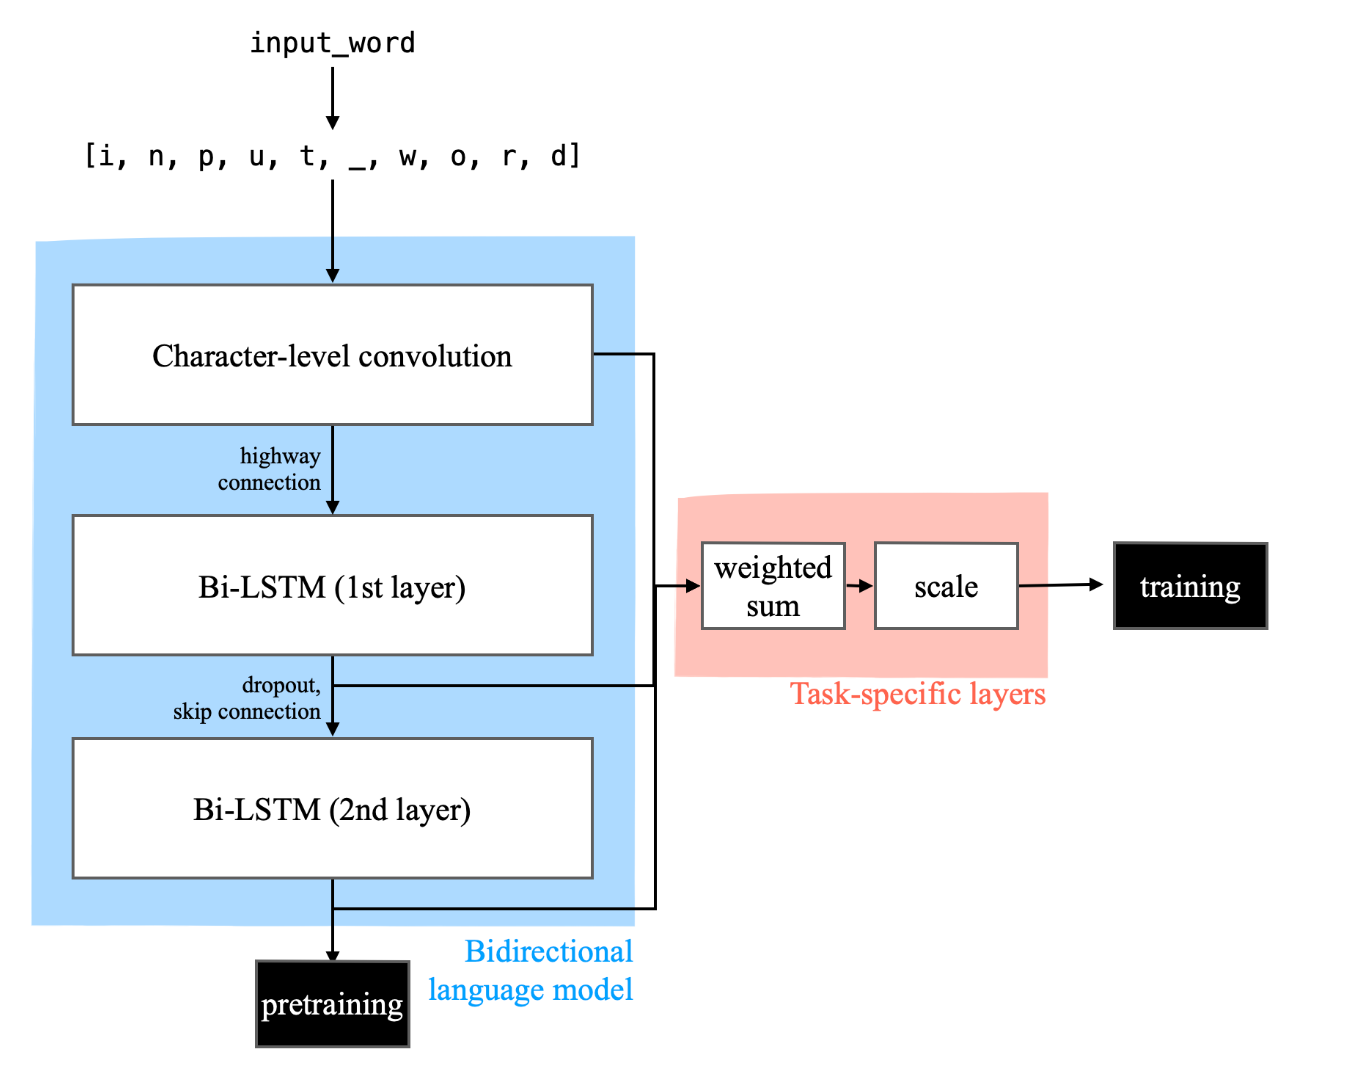
ELMO – Supervised Finetuning
ELMO – Supervised Finetuning
https://naturale0.github.io/2021/02/24/Understanding-ELMo
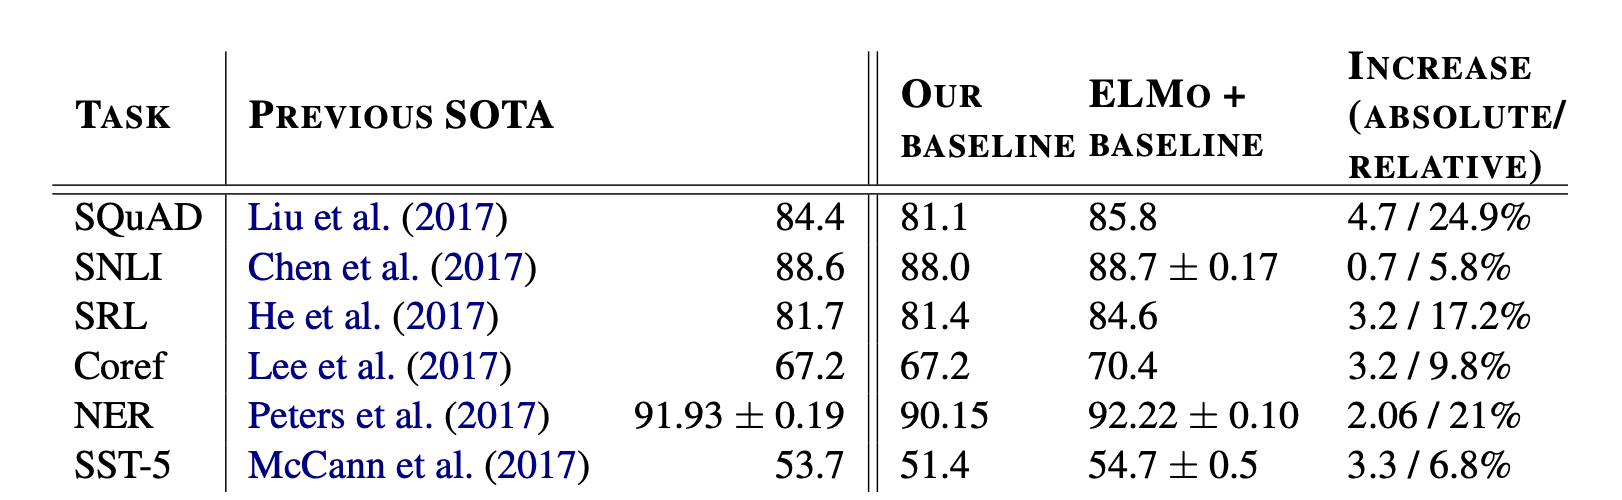
ELMO - Performance
ELMO - Performance
https://arxiv.org/pdf/1802.05365v2
2.3 Pretrained Language Models 2.3.2 Why Pretrained Models
2.3 Pretrained Language Models 2.3.2 Why Pretrained Models
Recall: Pretraining
Recall: Pretraining
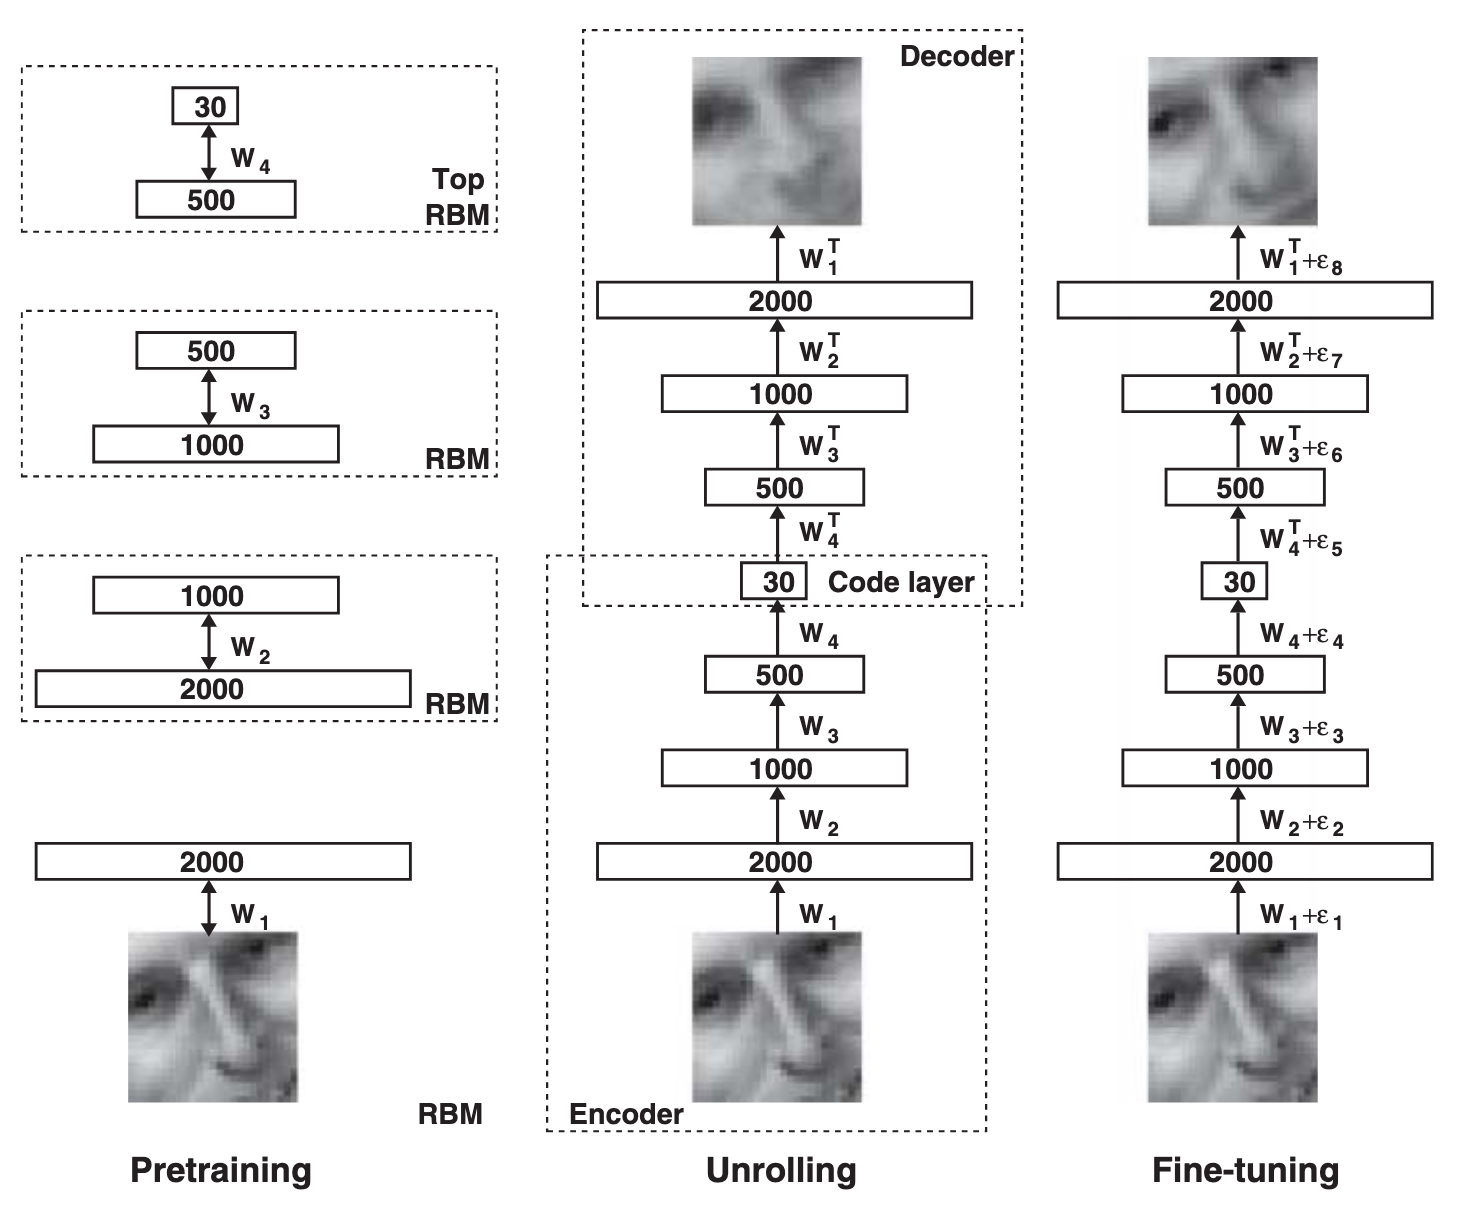
1.Hinton, G. E. & Salakhutdinov, R. R. Reducing the Dimensionality of Data with Neural Networks. Science 313, 504–507 (2006).
Pretraining
Pretraining
Unsupervised (or Self-supervised) Learn from a data-set;
Aims to recover the prior-distribution of the data;
Boltzmann Model for Image
Language Model of Language
Do not apply any further supervision! They harm the generalization!
Train a neural network to learn the distribution and save the weight.
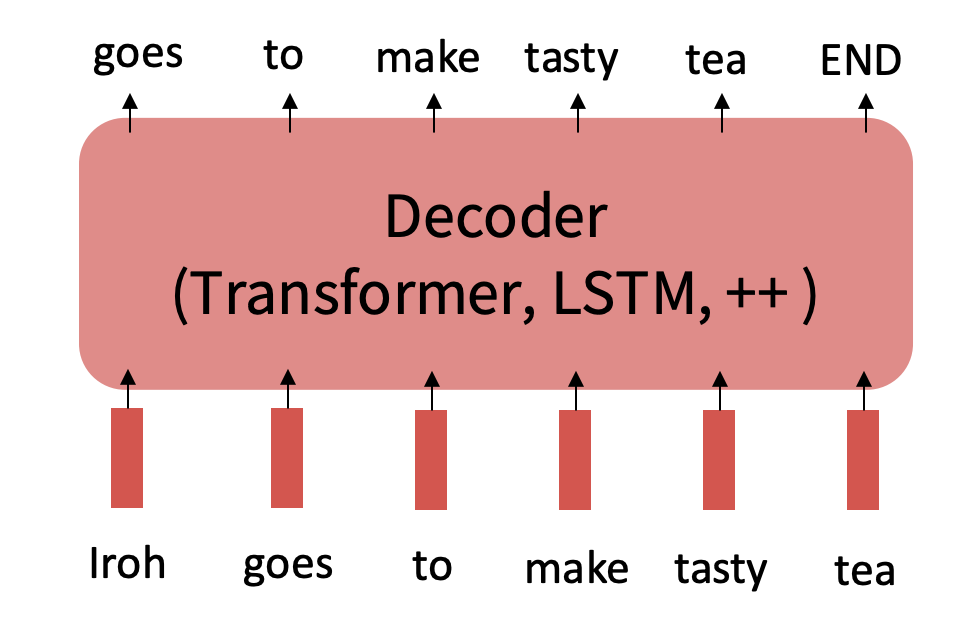
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
Pretraining-Finetuning Paradigm
Pretraining-Finetuning Paradigm
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
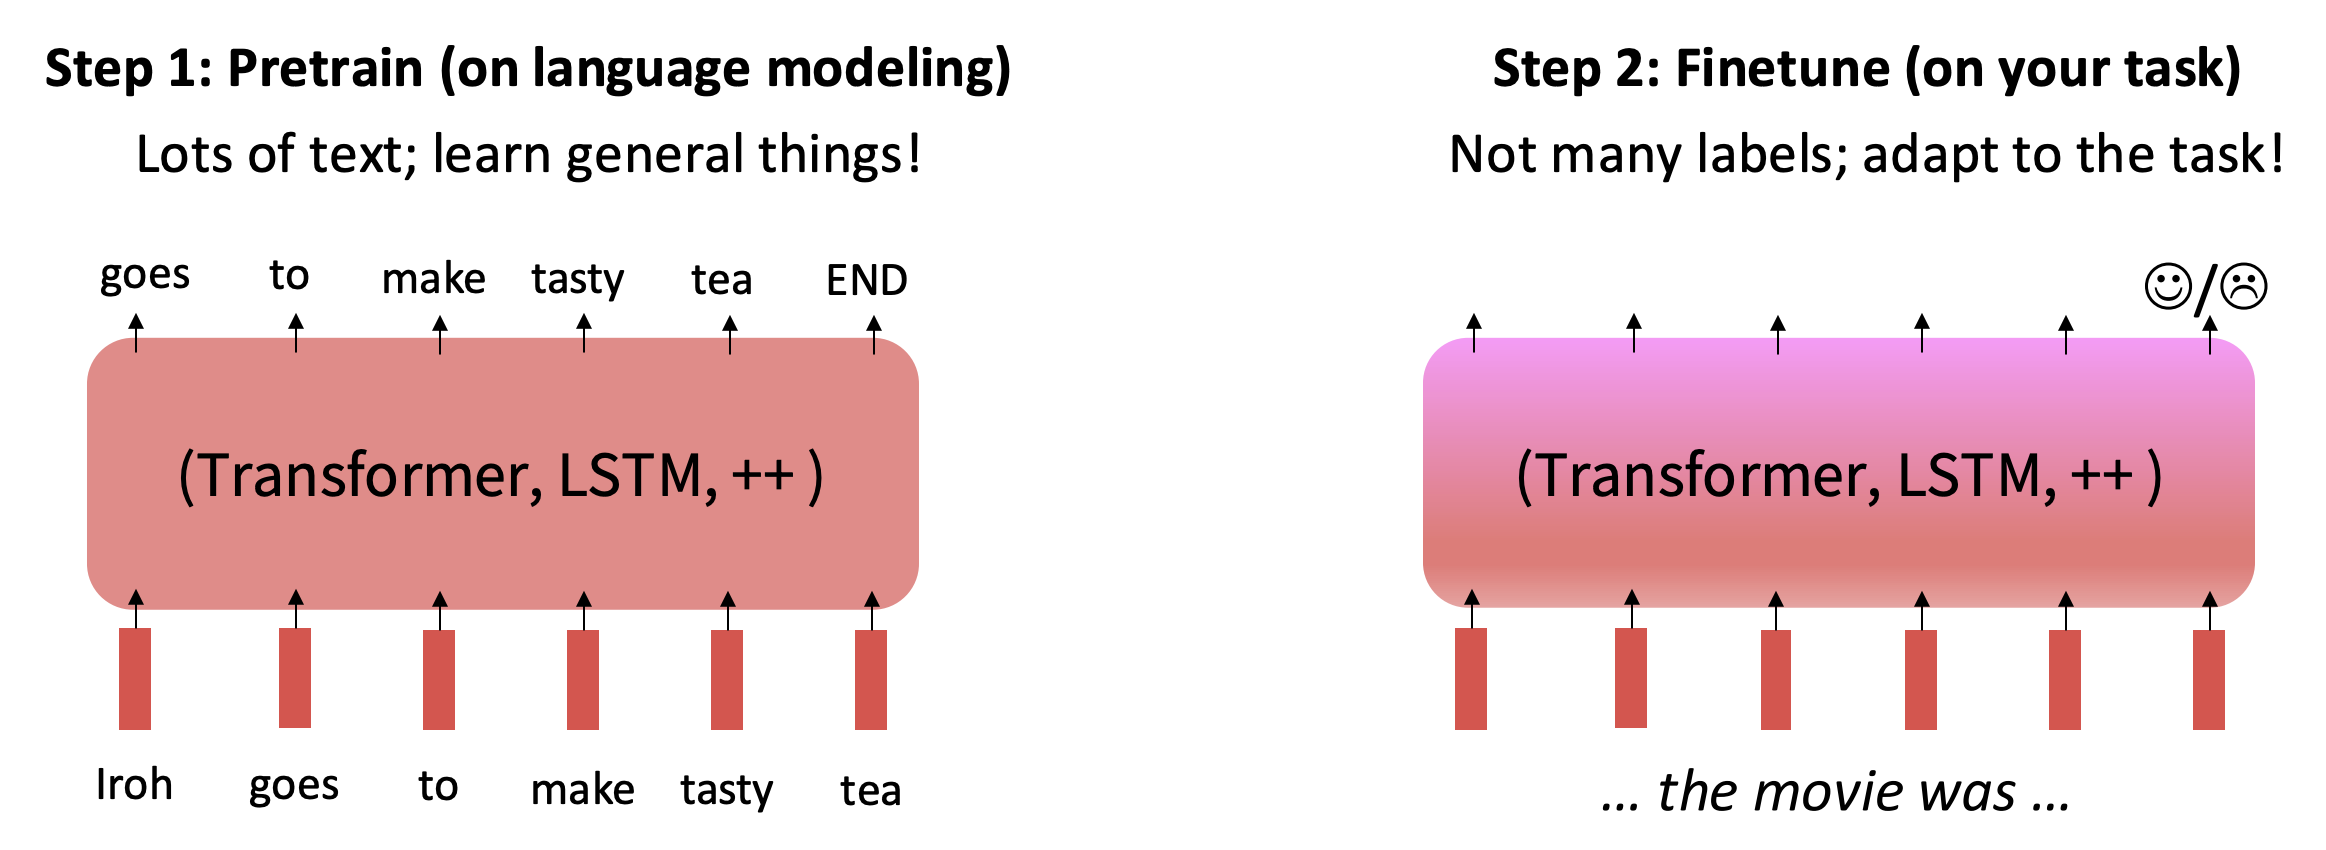
Why Pretrained Model?
Why Pretrained Model?
https://arxiv.org/pdf/1802.05365v2
Representation Learning
Sample Complexity
Optimization Theory
Bayesian Inference
Information Bottleneck
Representation Learning
Representation Learning
Pretraining serves as a form of unsupervised or self-supervised representation learning, which helps a model learn useful features from large-scale data.
In terms of statistical learning theory, this process reduces the hypothesis space the model must explore during downstream tasks.
Let be the hypothesis space of a model.
After pretraining, the model selects a subspace that is better aligned with natural data distributions.
The learning problem becomes easier and requires fewer labeled examples to generalize well.
This aligns with the bias-variance tradeoff: pretraining imposes a useful inductive bias (i.e., structural prior about the task or data distribution).
Data Efficiency and Transfer Learning
Data Efficiency and Transfer Learning
In settings with limited labeled data, training from scratch leads to overfitting due to high model complexity.
Pretrained models already encode generic knowledge, so fine-tuning requires only small amounts of data.
This can be analyzed through PAC-learning or sample complexity:
Pretraining reduces the sample complexity required to learn a task to within a desired generalization error .
Formally, the number of labeled examples needed scales with the effective capacity of the hypothesis class consistent with the pretrained features, which is often much smaller.
Optimization Landscape Improvement
Optimization Landscape Improvement
Deep neural networks suffer from highly non-convex loss surfaces with many local minima and saddle points. Pretraining provides a good initialization:
Gradient descent from a pretrained state converges faster and often to better local minima.
This is linked to ideas from meta-learning: the pretrained model is already near a “task manifold” in parameter space.
The benefit can also be seen from the perspective of energy-based models where pretraining shapes the energy landscape so that desirable modes (i.e., good solutions) are more easily reachable.
Bayesian View: Prior Knowledge
Bayesian View: Prior Knowledge
From a Bayesian perspective, pretraining can be interpreted as providing a prior distribution over model parameters ,learned from large unlabeled data.
Fine-tuning becomes a posterior inference given a new (supervised) task and its data D:
The pretrained model provides a strong informative prior that narrows the posterior and improves generalization on new tasks.
This view also supports the empirical success of few-shot and zero-shot learning in pretrained models like GPT and BERT.
Information Bottleneck Theory
Information Bottleneck Theory
The Information Bottleneck (IB) principle suggests learning representations that compress the input while retaining task-relevant information.
Pretraining can be viewed as maximizing mutual information between inputs x and intermediate representations z, while minimizing only later in fine-tuning.
This staged process can improve generalization by avoiding overfitting in early stages.
Why Pretrained Model?
Why Pretrained Model?
Perspective | Pretraining Benefit |
Representation Learning | Narrows hypothesis space, induces task-relevant structure |
Sample Complexity | Reduces labeled data needed for good generalization |
Optimization Theory | Provides better initialization for gradient descent |
Bayesian Inference | Acts as a learned prior, guiding parameter estimation |
Information Bottleneck | Encourages compressed but expressive representations |
Think: When we Need Pretraining?
Think: When we Need Pretraining?
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
AGI unifies all task in Dialog/QA scenario.
Can we just train a supervised model using all Dialog/QA data?
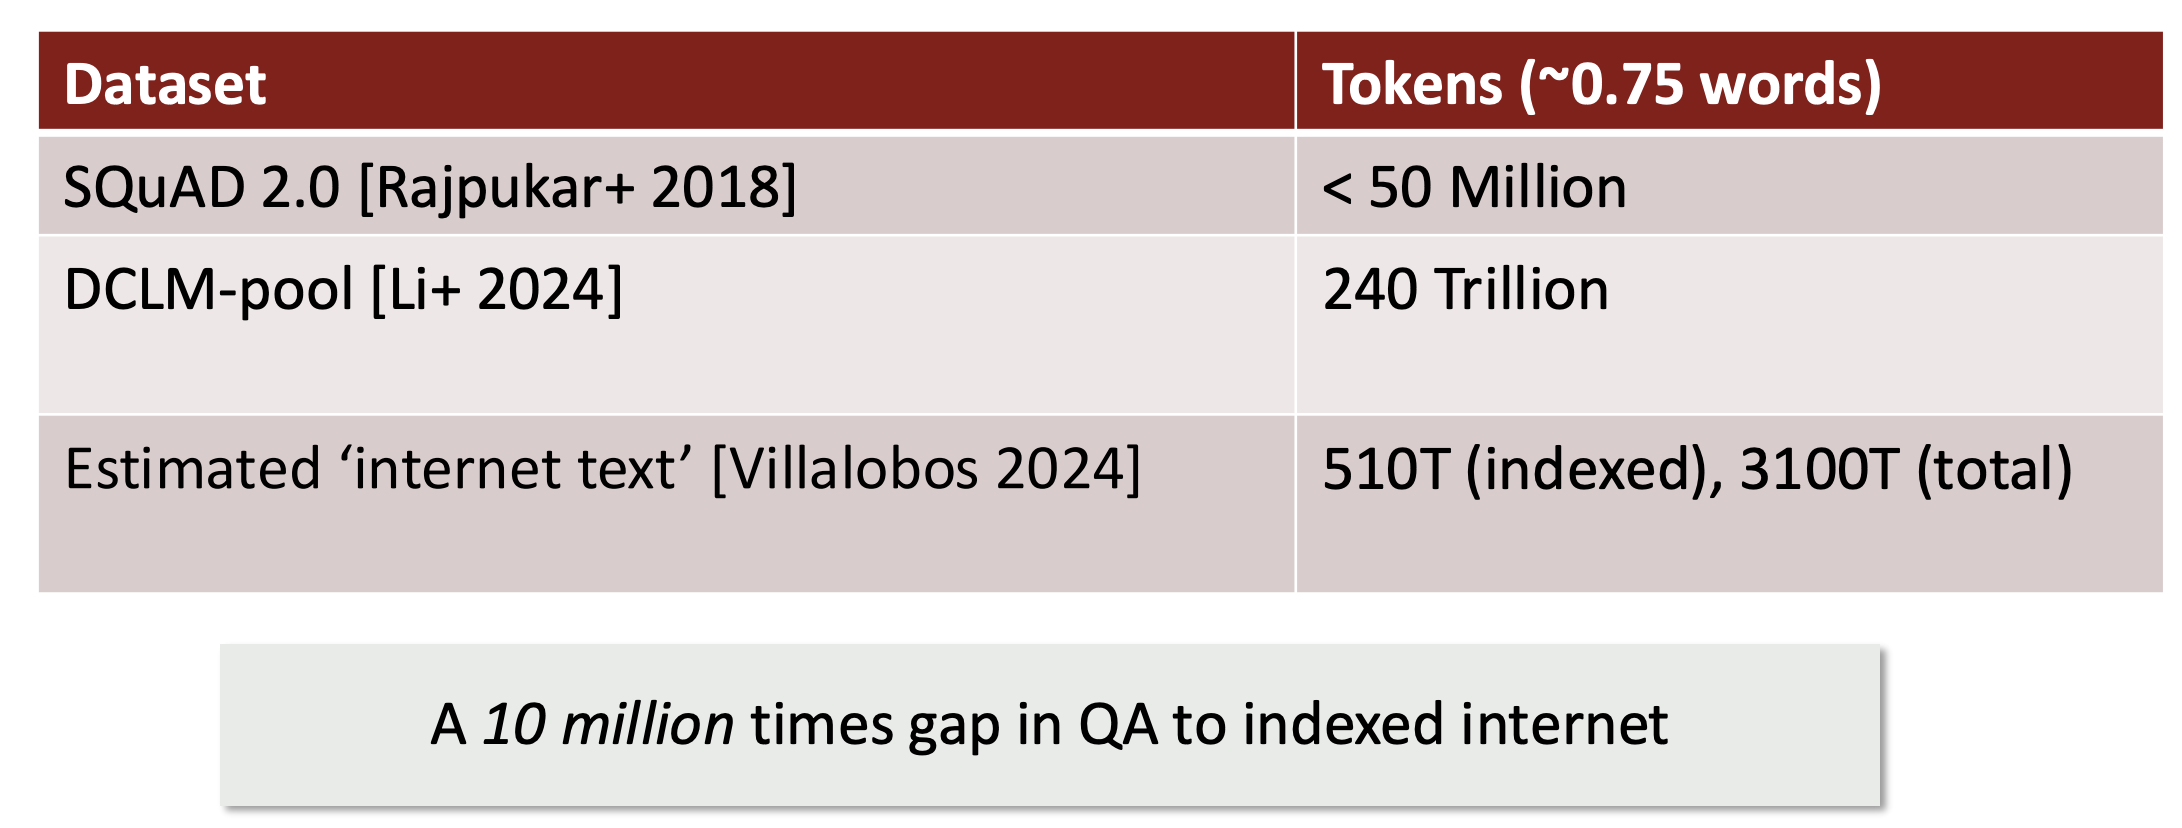
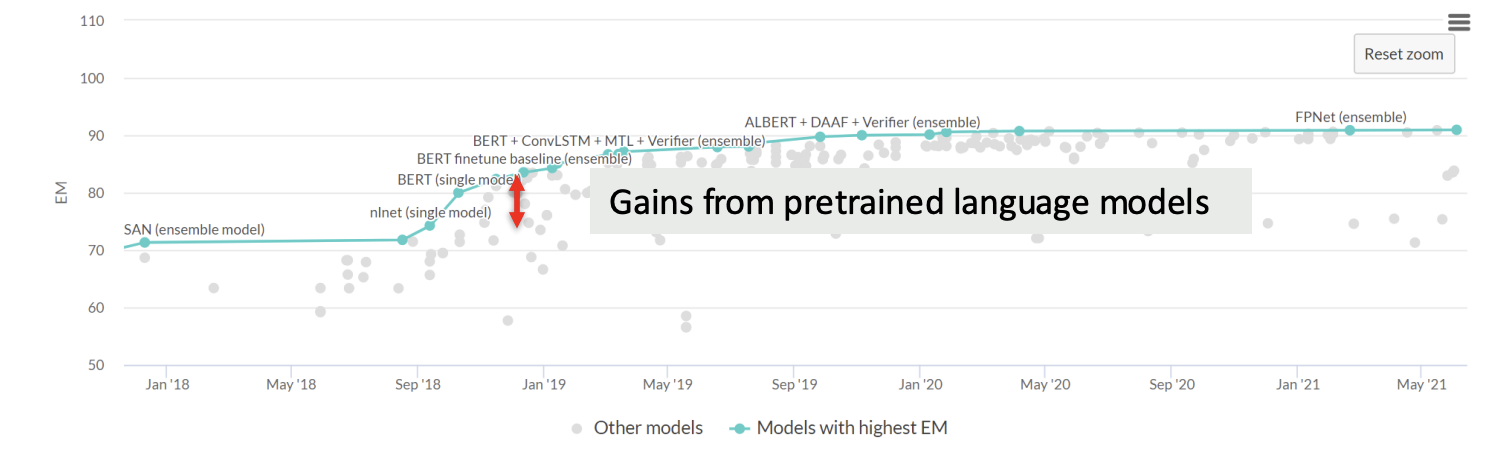
2018: Year of Pretrained Model
2018: Year of Pretrained Model
AI2 made ELMo in spring 2018;
GPT (transformer-based ELMo) was released in summer 2018;
BERT came out October 2018.
The Pretrain Revolution
The Pretrain Revolution
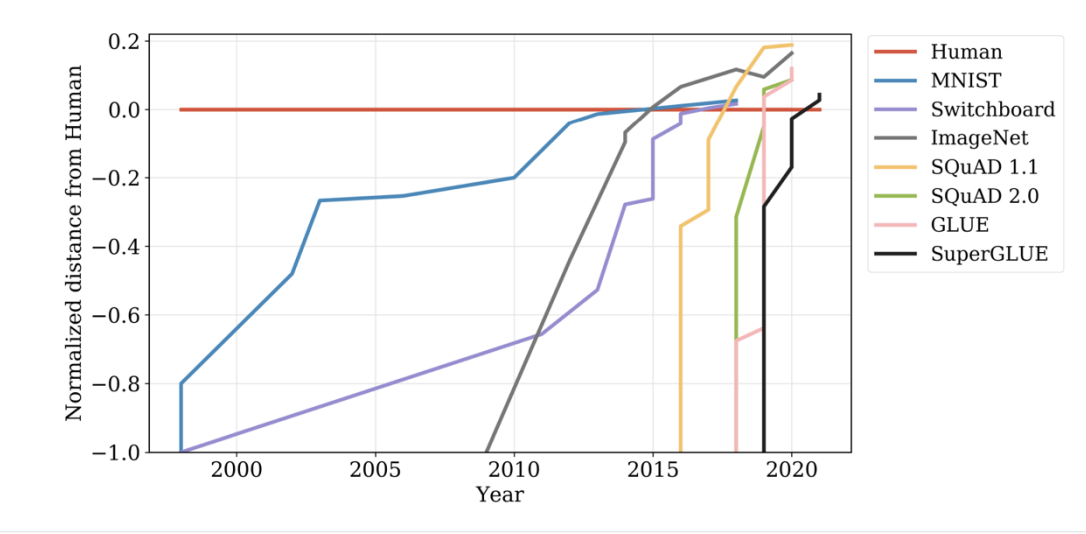
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
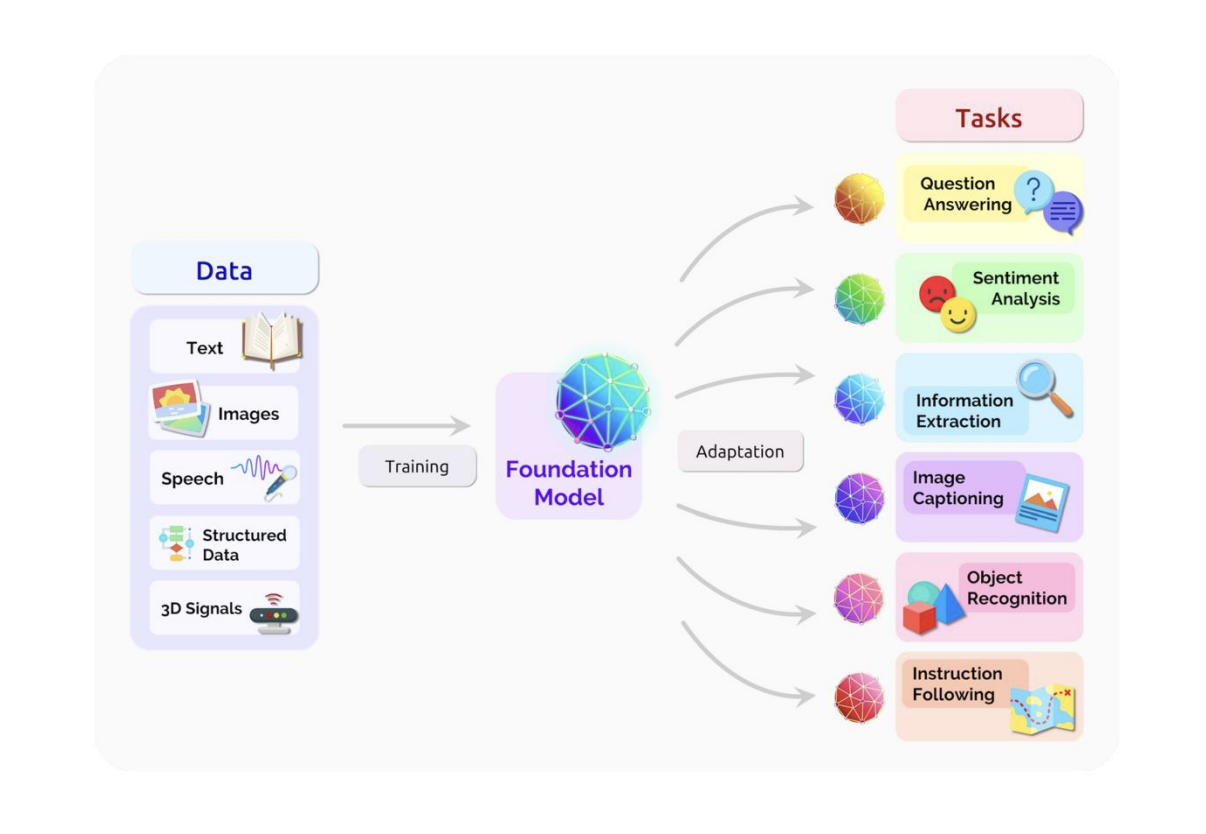
The Pretrain Revolution
The Pretrain Revolution
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
The Pretrain Revolution
The Pretrain Revolution
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
2.3 Pretrained Language Models 2.3.3 GPT: Autoregressive Pretraining
2.3 Pretrained Language Models 2.3.3 GPT: Autoregressive Pretraining
GPT (Open AI, 2018)
GPT (Open AI, 2018)
https://medium.com/data-science/understanding-the-evolution-of-gpt-part-1-an-in-depth-look-at-gpt-1-and-what-inspired-it-b7388a32e87d
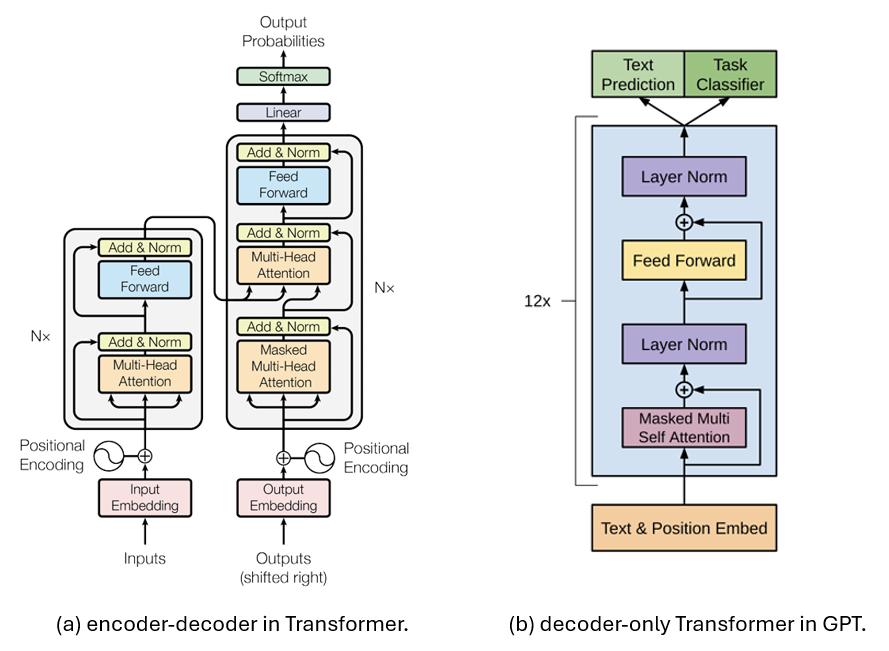
Trained on BooksCorpus dataset (7000 books), 3 epochs.
GPT - Training
GPT - Training
Back of the fixed context window – k:
Trained on BooksCorpus dataset (7000 books), 3 epochs.
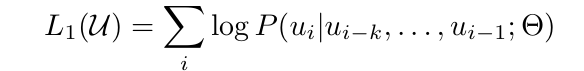
GPT- Supervised Finetuning
GPT- Supervised Finetuning
Improving Language Understanding by Generative Pre-Training, Open AI, 2018
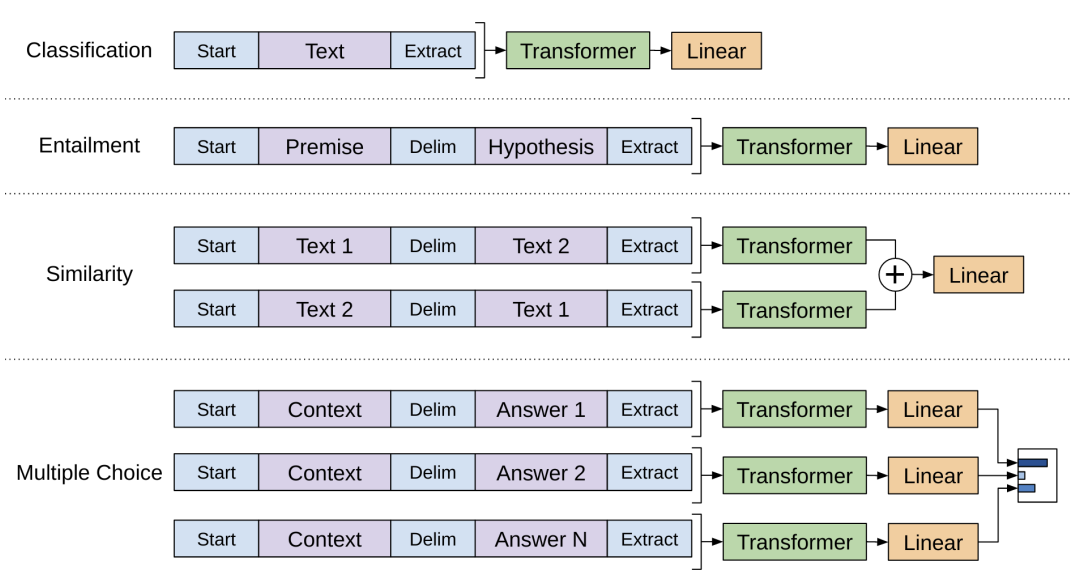
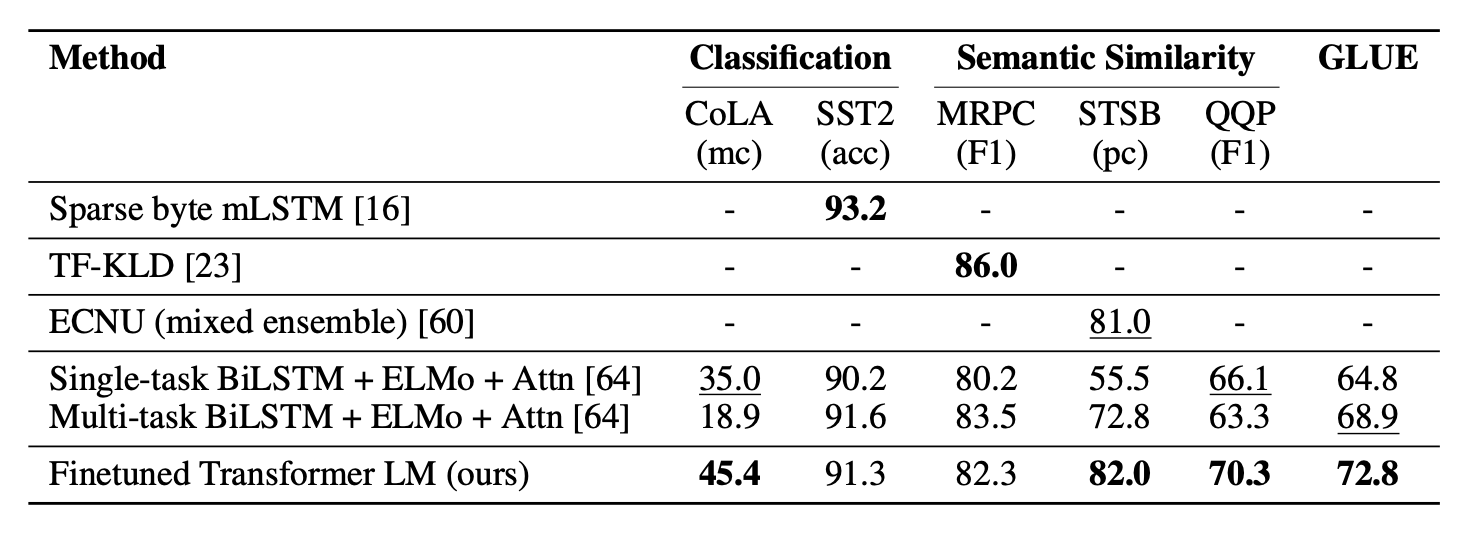
GPT- Performance
GPT- Performance
Improving Language Understanding by Generative Pre-Training, Open AI, 2018
GPT: Pretraining + Transformer
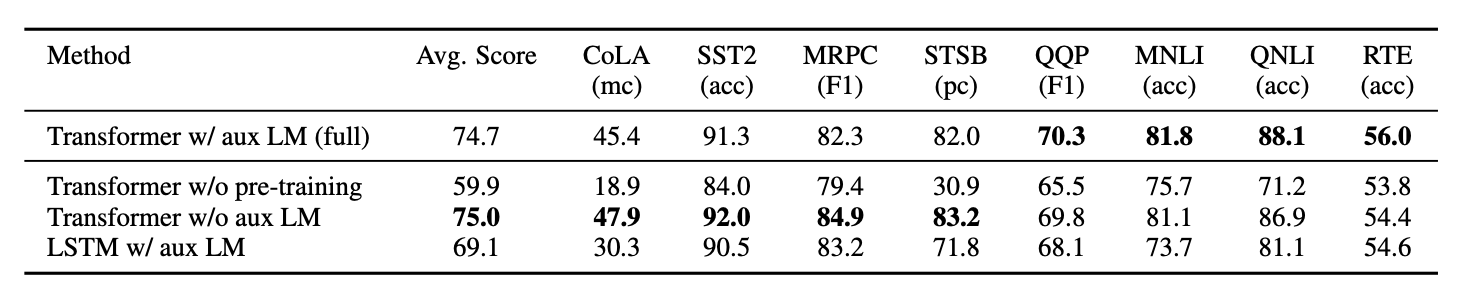
GPT: Pretraining + Transformer
Improving Language Understanding by Generative Pre-Training, Open AI, 2018
GPT 1, GPT 2, and GPT 3
GPT 1, GPT 2, and GPT 3
https://360digitmg.com/blog/types-of-gpt-in-artificial-intelligence
GPT-1 | GPT-2 | GPT-3 | |
Parameters | 117 Million | 1.5 Billion | 175 Billion |
Decoder Layers | 12 | 48 | 96 |
Context Token Size | 512 | 1024 | 2048 |
Hidden Layer | 768 | 1600 | 12288 |
Batch Size | 64 | 512 | 3.2M |
GPT 2: Increasingly convincing generations
GPT 2: Increasingly convincing generations
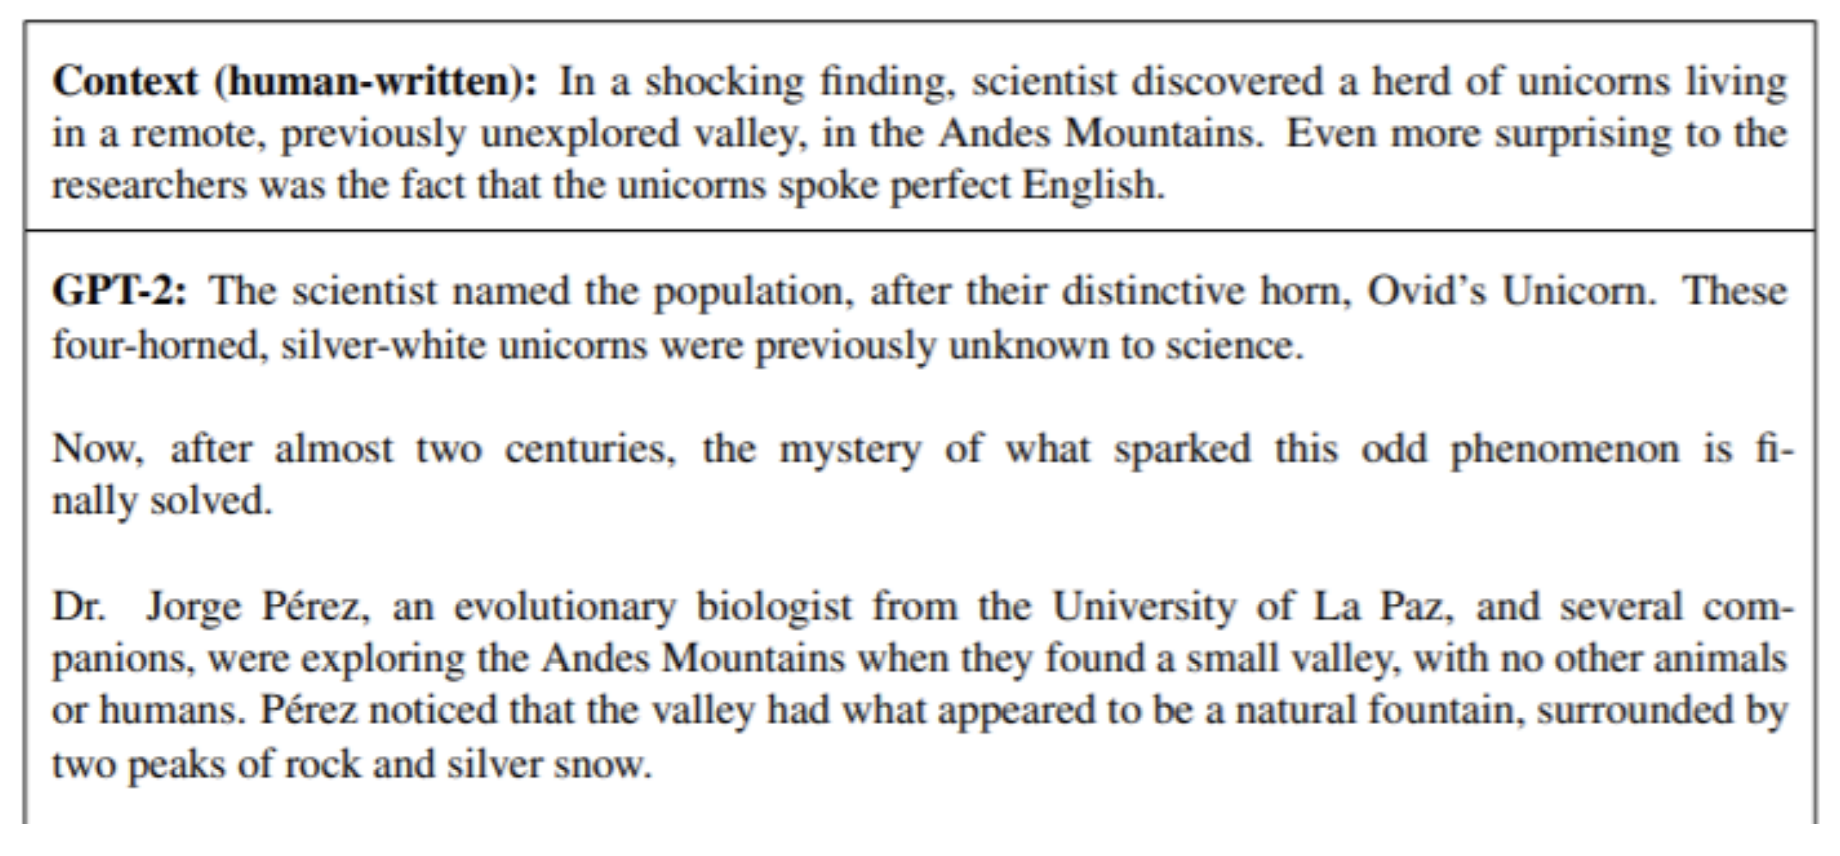
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
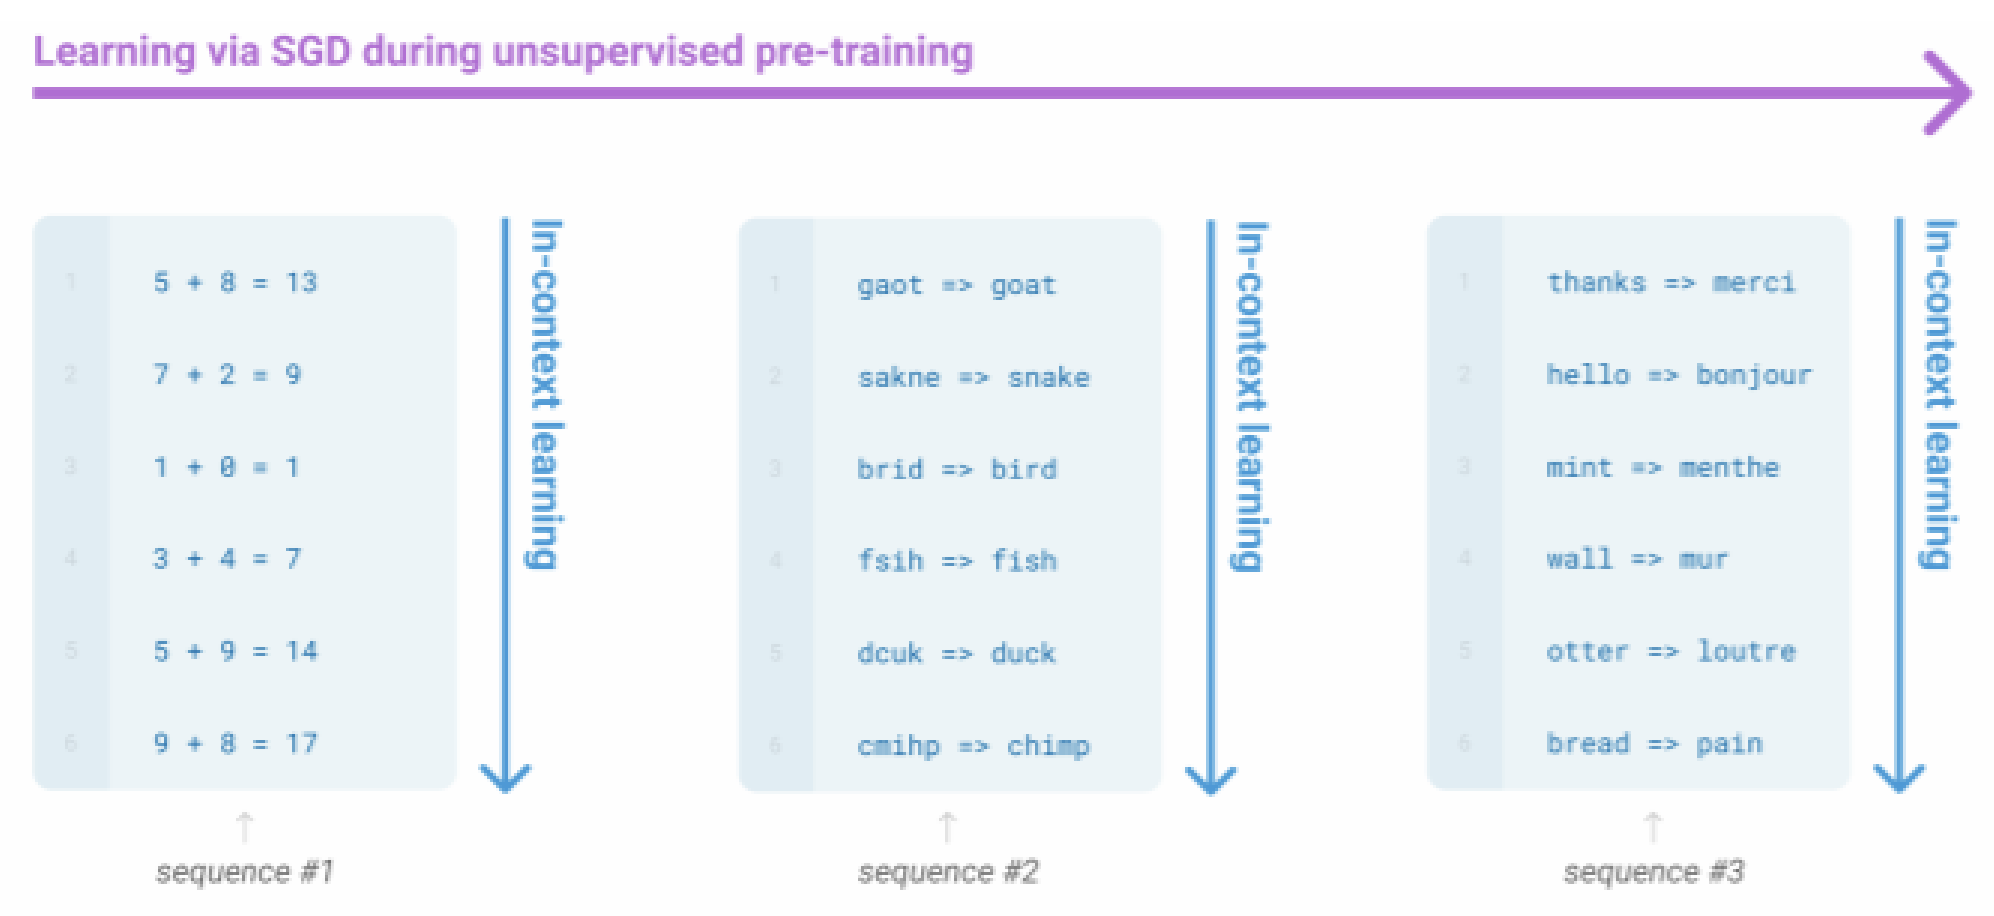
GPT 3: Very large models and In-context learning
GPT 3: Very large models and In-context learning
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
Perform some kind of learning without gradient steps simply from examples you provide within their contexts.
2.3 Pretrained Language Models 2.3.4 BERT: Masked Language Modeling
2.3 Pretrained Language Models 2.3.4 BERT: Masked Language Modeling
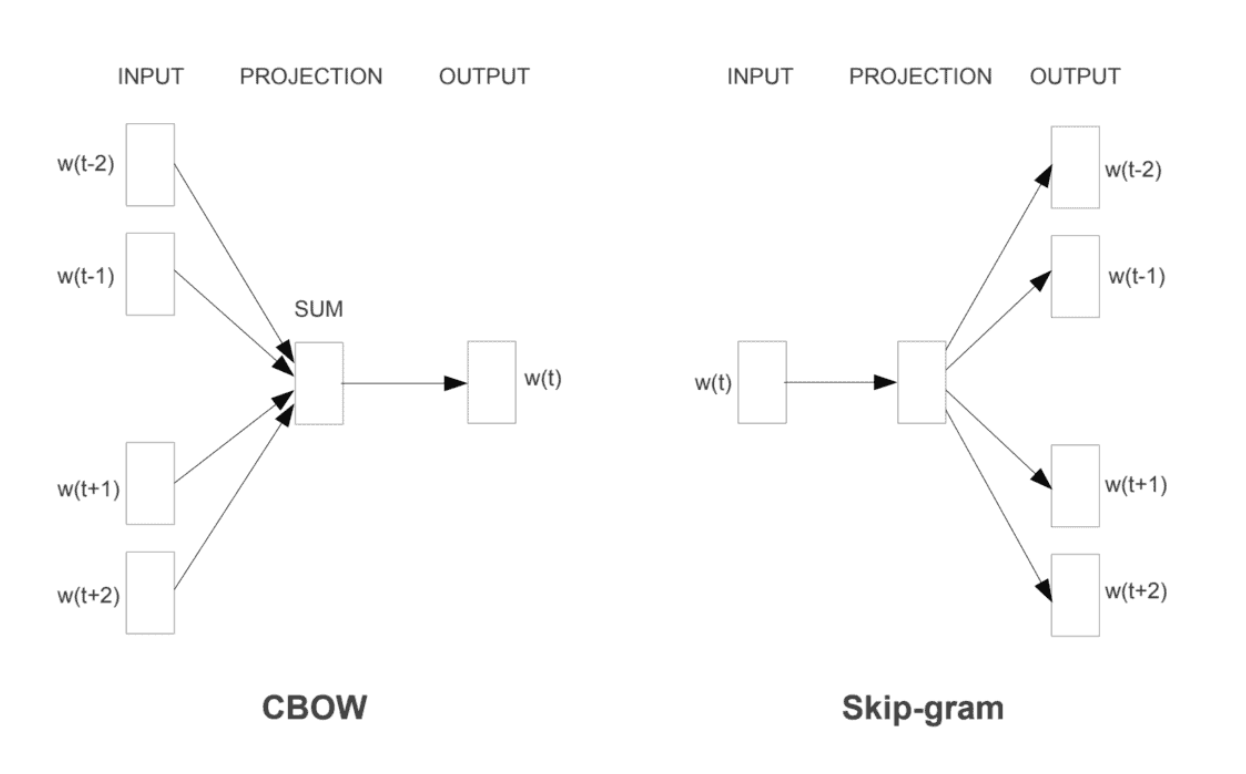
Lets focus on Embedding
Lets focus on Embedding
https://www.baeldung.com/cs/word-embeddings-cbow-vs-skip-gram
Language Modeling and Embedding
Language Modeling and Embedding
Recall: Words are defined by their environments (the words around them);
CBOW and Skip-Gram(Word2Vec): Full environment;
Language Model: Partial Environment (Only History)
Language Model + RNN/Transformer = ELMO/GPT
CBOW/Skip-Gram + RNN/Transformers = ?
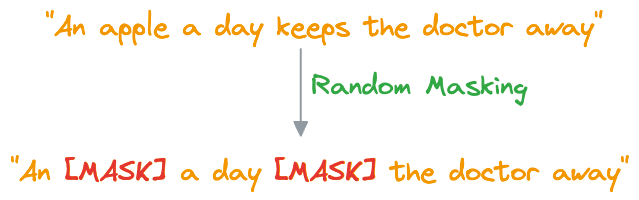
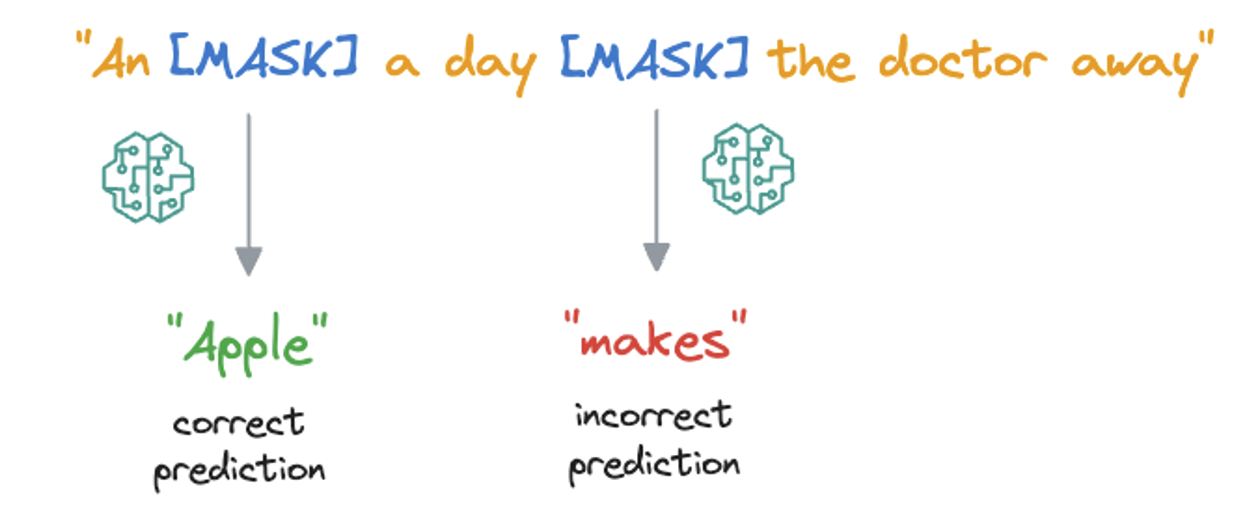
From CBOW/SG to Masked Language Model
From CBOW/SG to Masked Language Model
https://www.dailydoseofds.com/bi-encoders-and-cross-encoders-for-sentence-pair-similarity-scoring-part-1/
Masked Language Model
Masked Language Model
https://slds-lmu.github.io/seminar_nlp_ss20/transfer-learning-for-nlp-ii.html
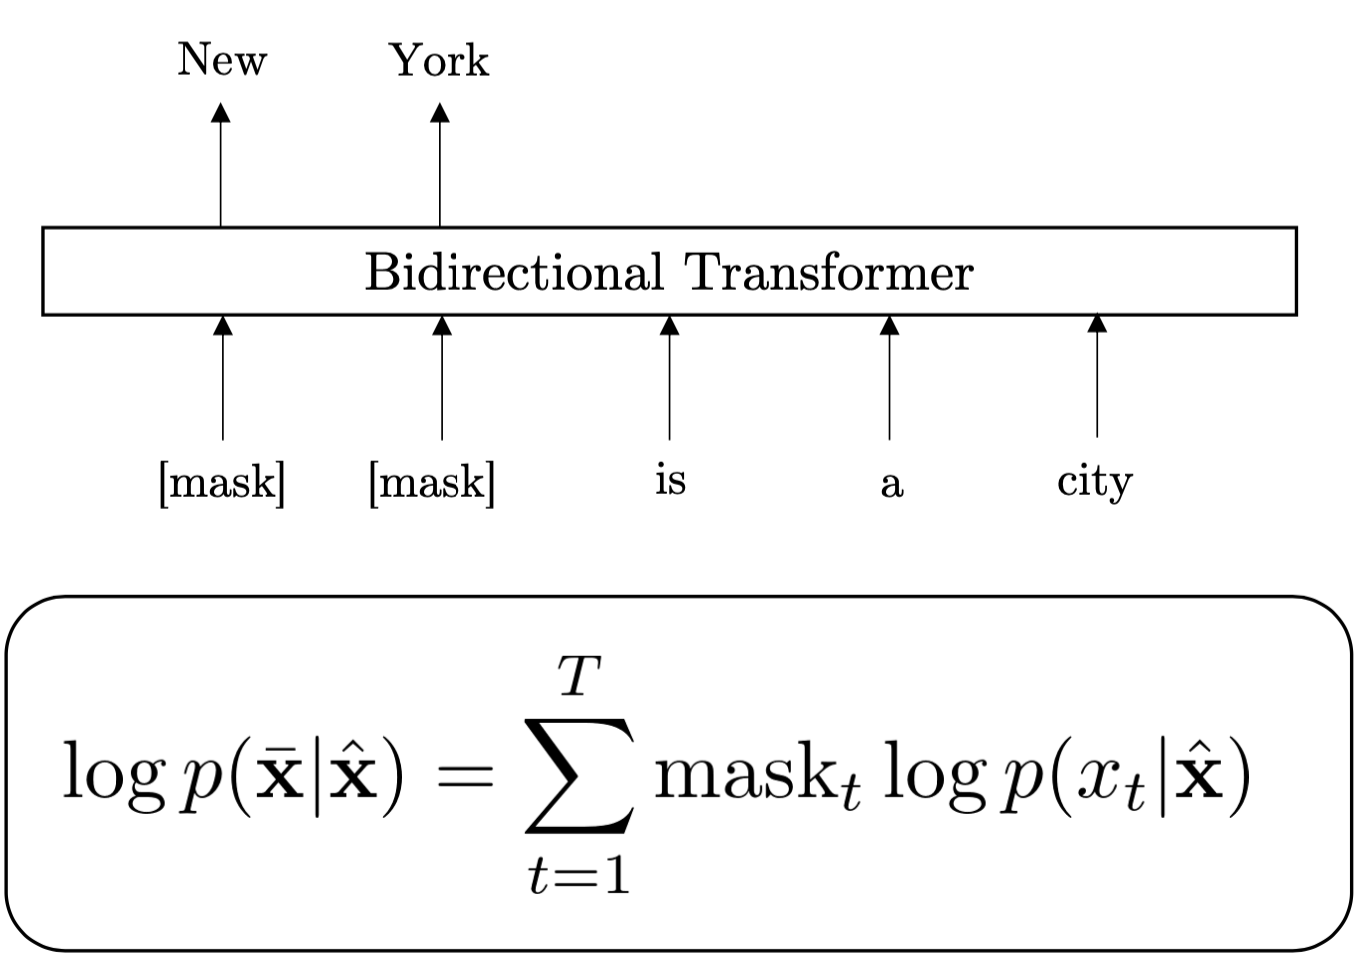
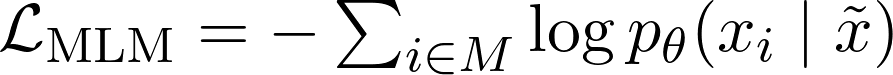
BERT (Bidirectional Encoder Representations from Transformers) = MLM+ Transformers
BERT (Bidirectional Encoder Representations from Transformers) = MLM+ Transformers
BERT implement following two tasks using Transformer:
Masked Language Modeling
Next Sentence Prediction
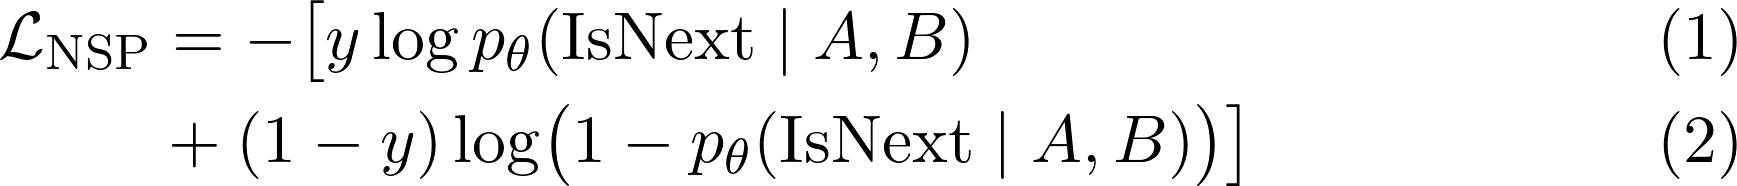
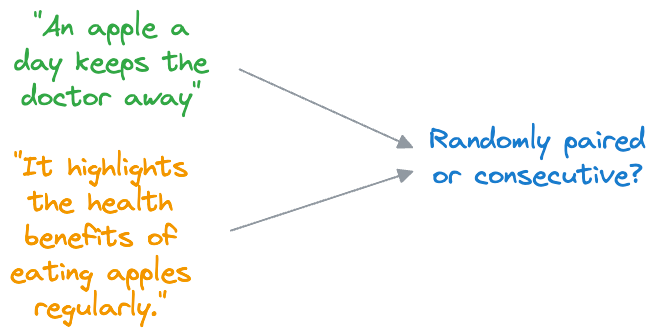
https://www.dailydoseofds.com/bi-encoders-and-cross-encoders-for-sentence-pair-similarity-scoring-part-1/
Input Representation
Input Representation
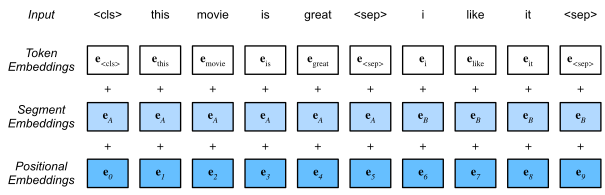
https://d2l.ai/chapter_natural-language-processing-pretraining/bert.html
Masked Token Prediction
Masked Token Prediction
https://jalammar.github.io/illustrated-bert/
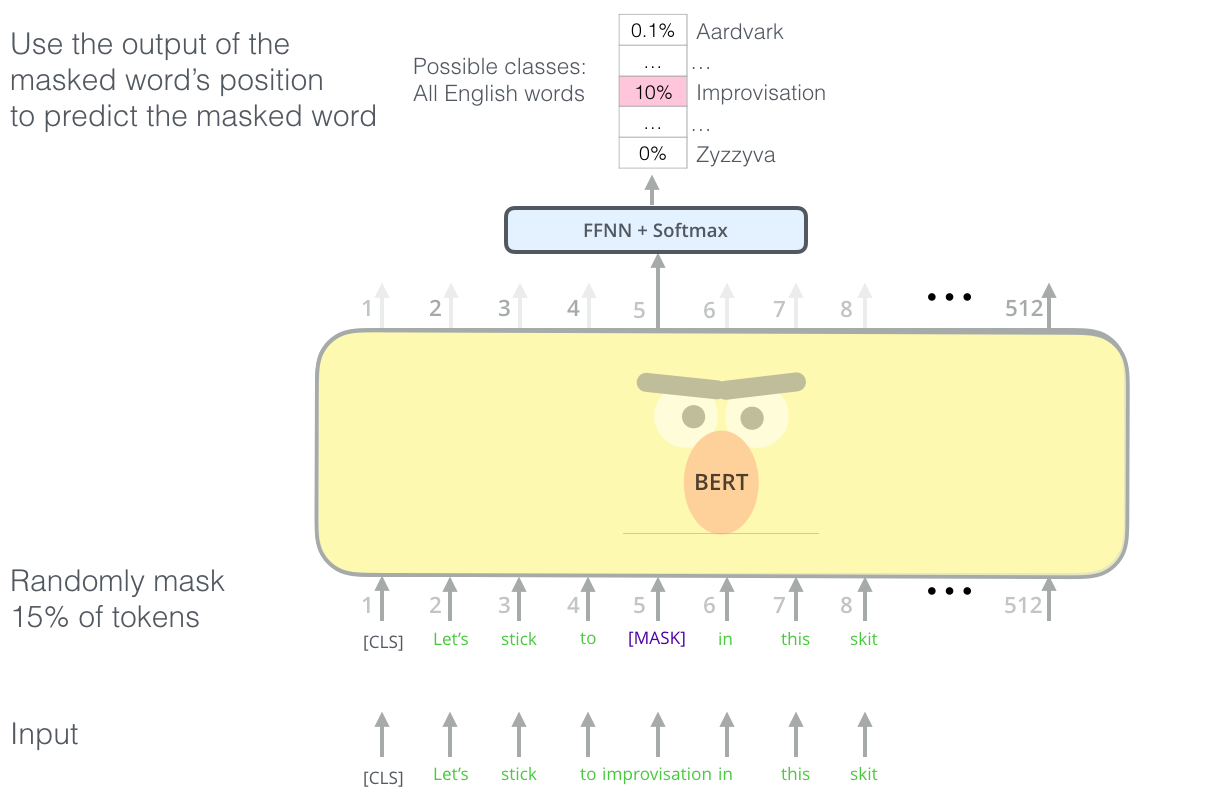
How to Mask?
How to Mask?
15% of tokens in each sequence will be randomly masked.
How to mask?
80% of the time: Replace the word with the [MASK] token, e.g., my dog is hairy ⇒ my dog is [MASK]
10% of the time: Replace the word with a random word, e.g., my dog is hairy ⇒ my dog is apple.
10% of the time: Keep the word unchanged, e.g., my dog is hairy ⇒ my dog is hairy.
Why last two operators?
Next Sentence Prediction
Next Sentence Prediction
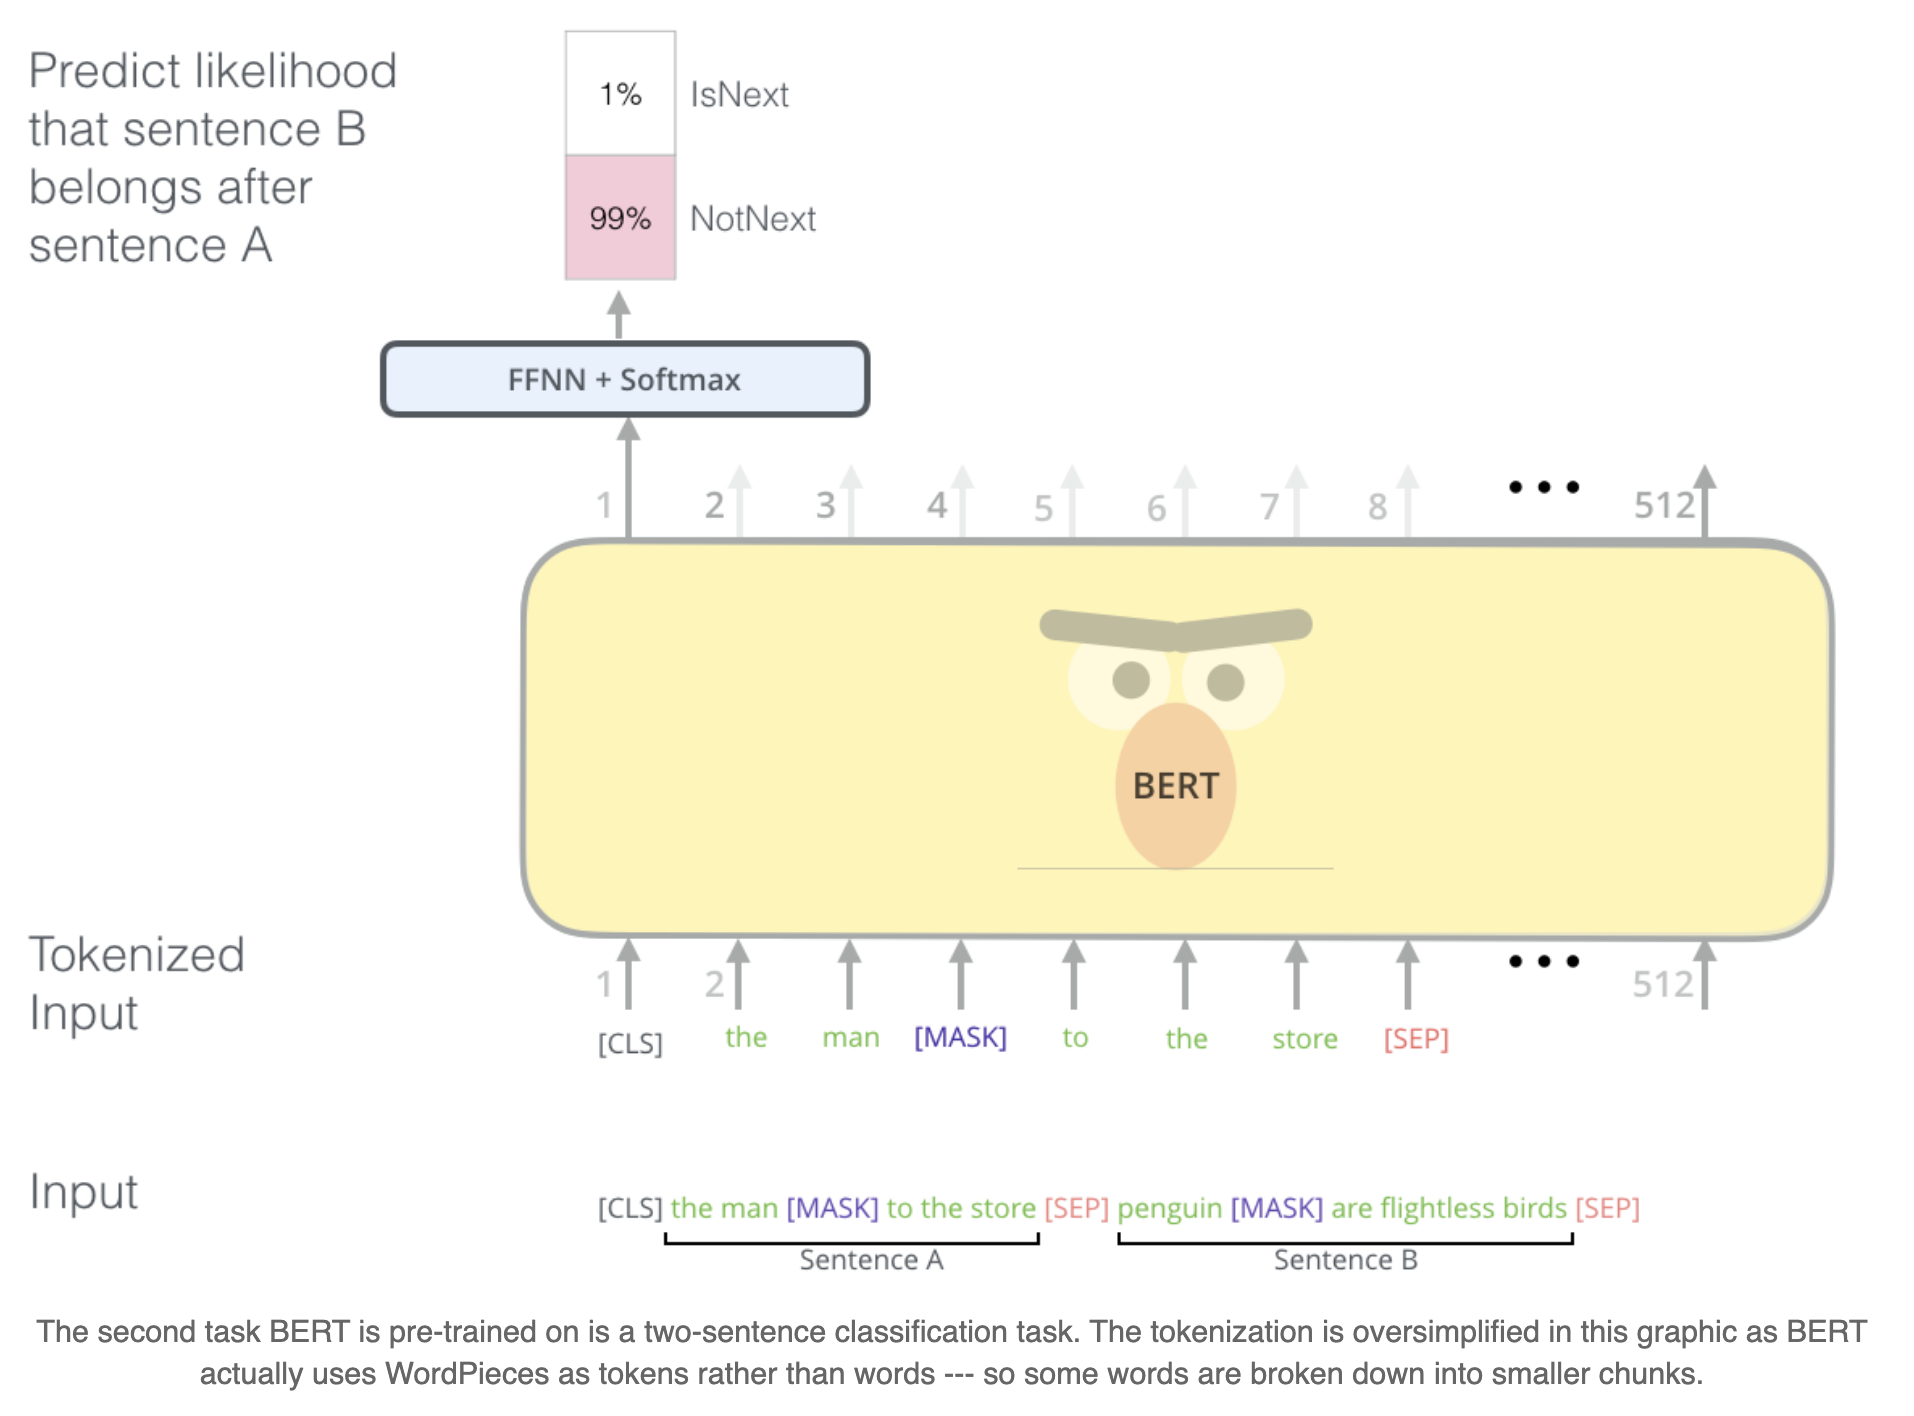
https://jalammar.github.io/illustrated-bert/
Training the Pretrain Model
Training the Pretrain Model
Training Corpus:
BooksCorpus (800M words)
English Wikipedia (2,500M words)
Versions (L stands for the number of layers, H stands for the hidden size, A stands for the number of self-attention heads):
BERT-Base: L = 12, H = 768, A = 12, Total parameters = 110M
BERT-Large: L = 24, H = 1024, A = 16, Total parameters = 340M
Finetuning for Tasks
Finetuning for Tasks
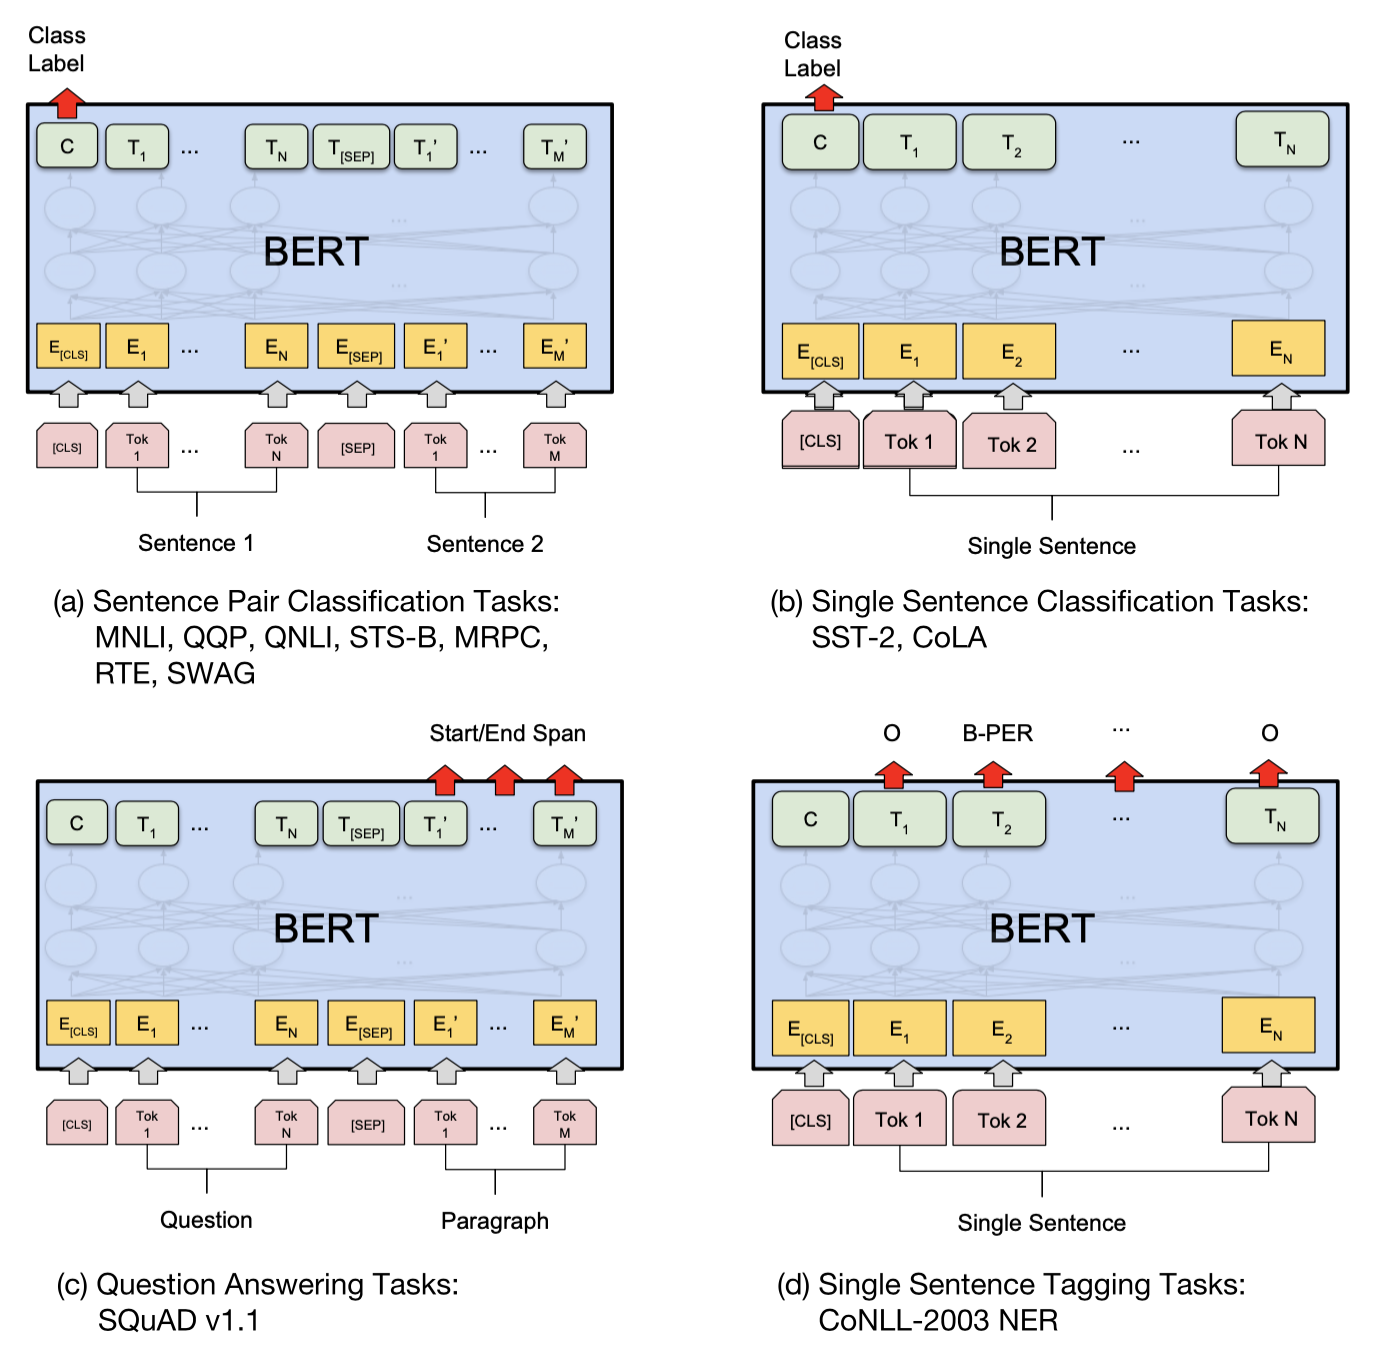
https://jalammar.github.io/illustrated-bert/
Bert for Feature Extraction
Bert for Feature Extraction
https://jalammar.github.io/illustrated-bert/
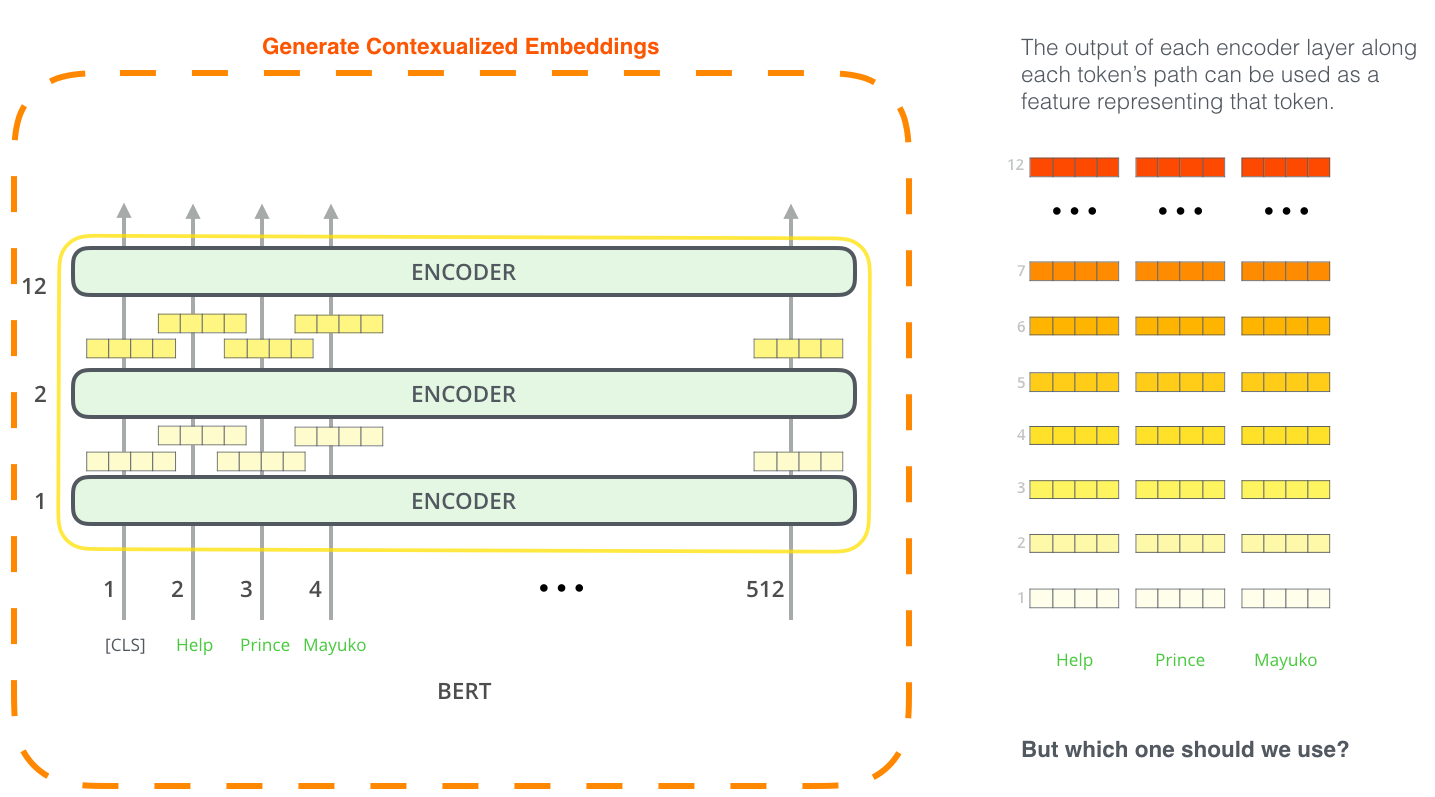
Bert for Feature Extraction
Bert for Feature Extraction
https://jalammar.github.io/illustrated-bert/
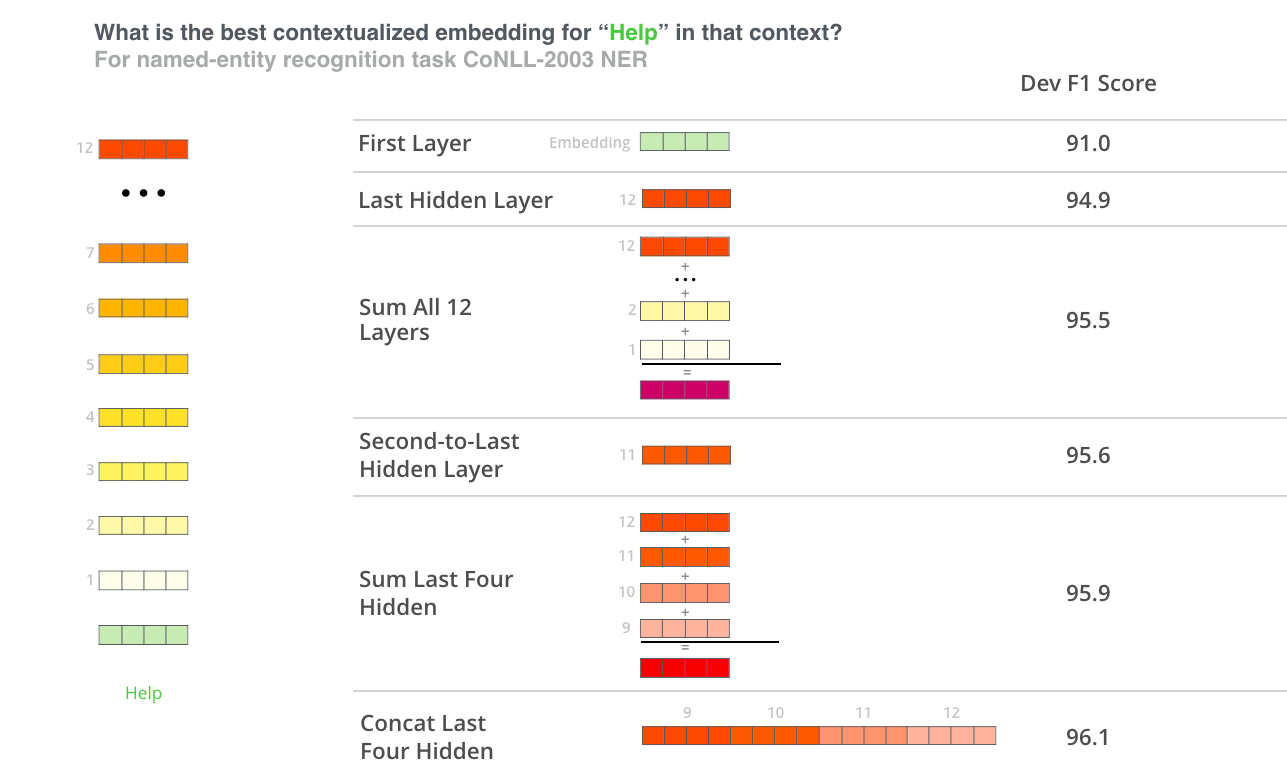
2.3 Pretrained Language Models 2.3.5 T5: Encoder–Decoder Pretraining
2.3 Pretrained Language Models 2.3.5 T5: Encoder–Decoder Pretraining
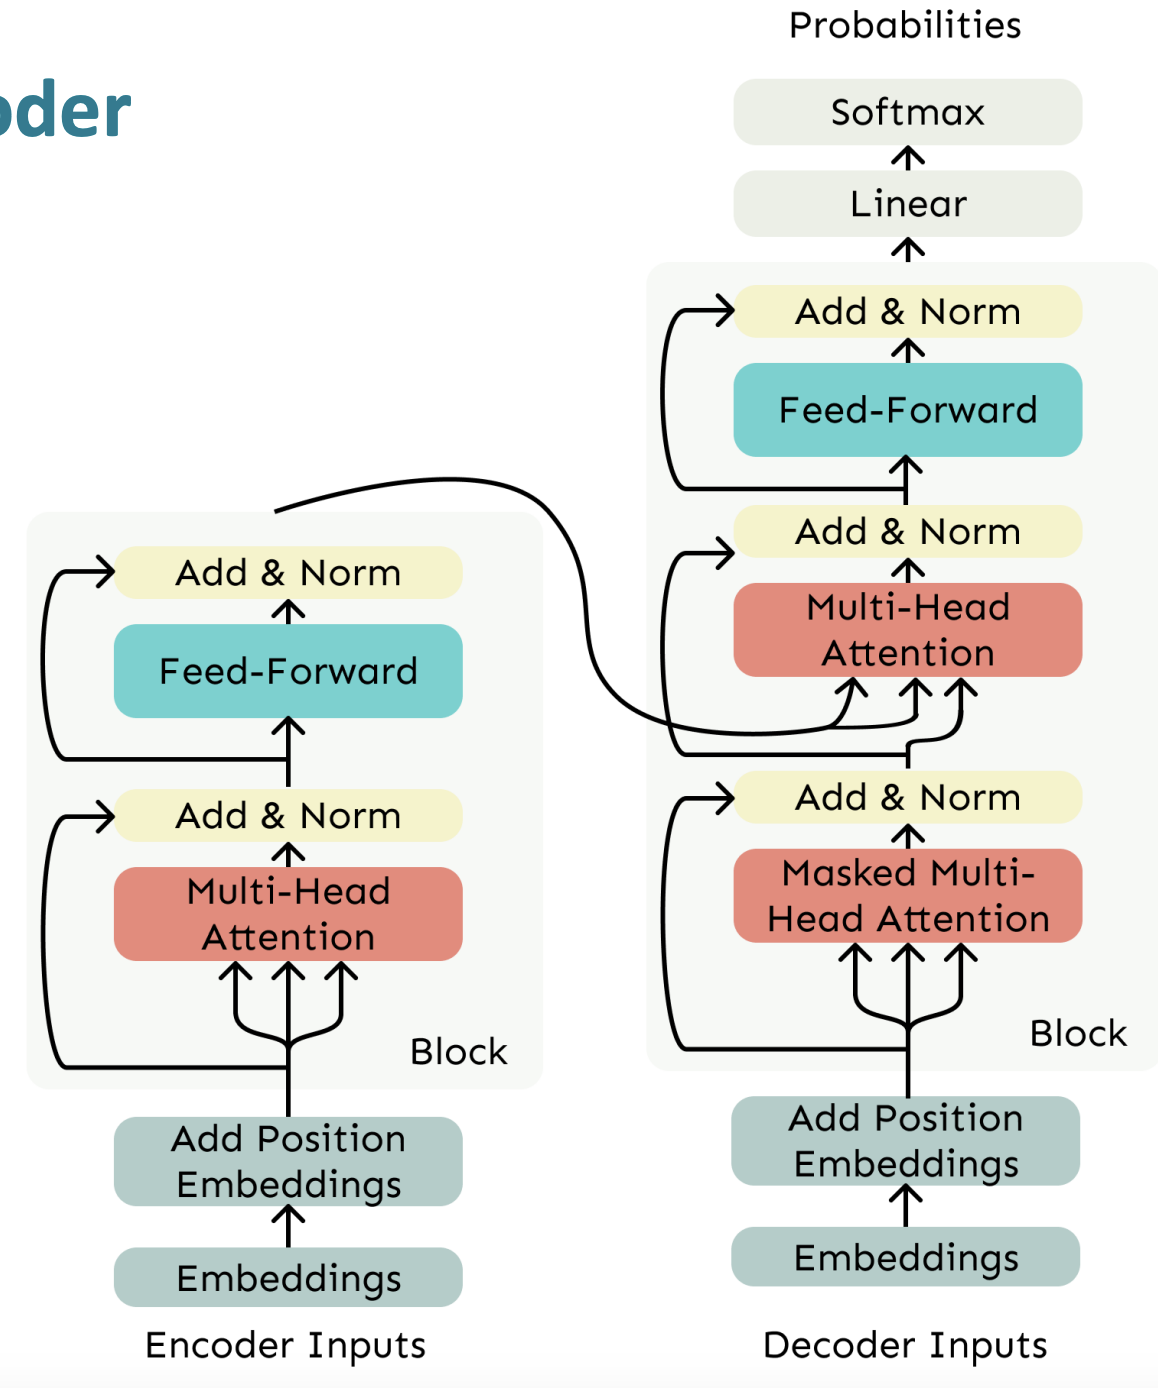
Transformers Pretrained Models
Transformers → Pretrained Models
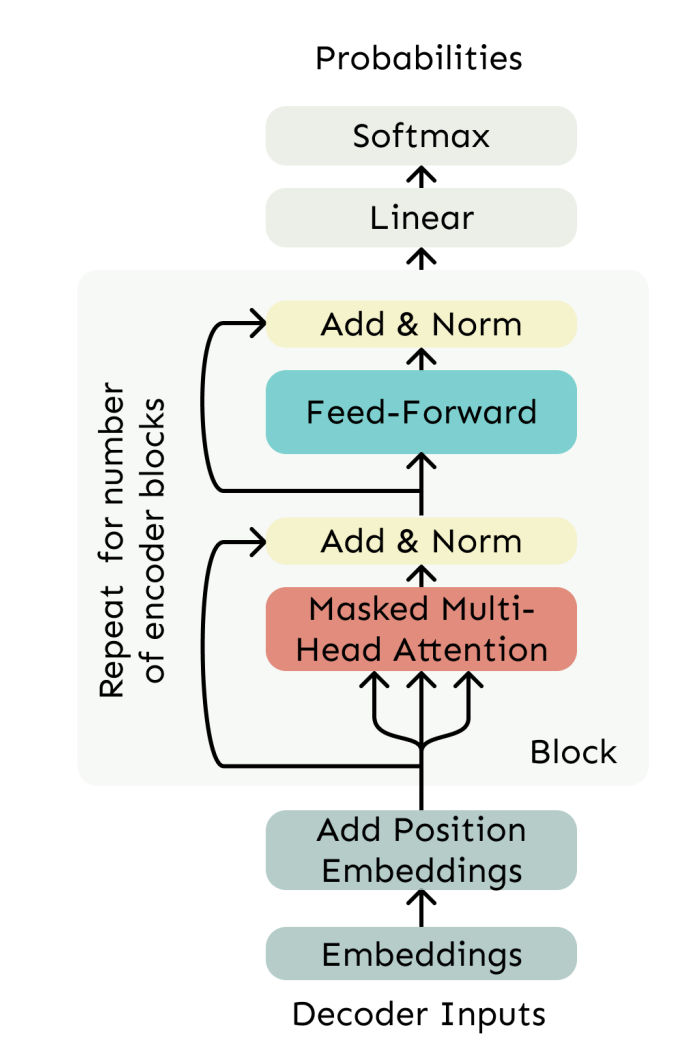
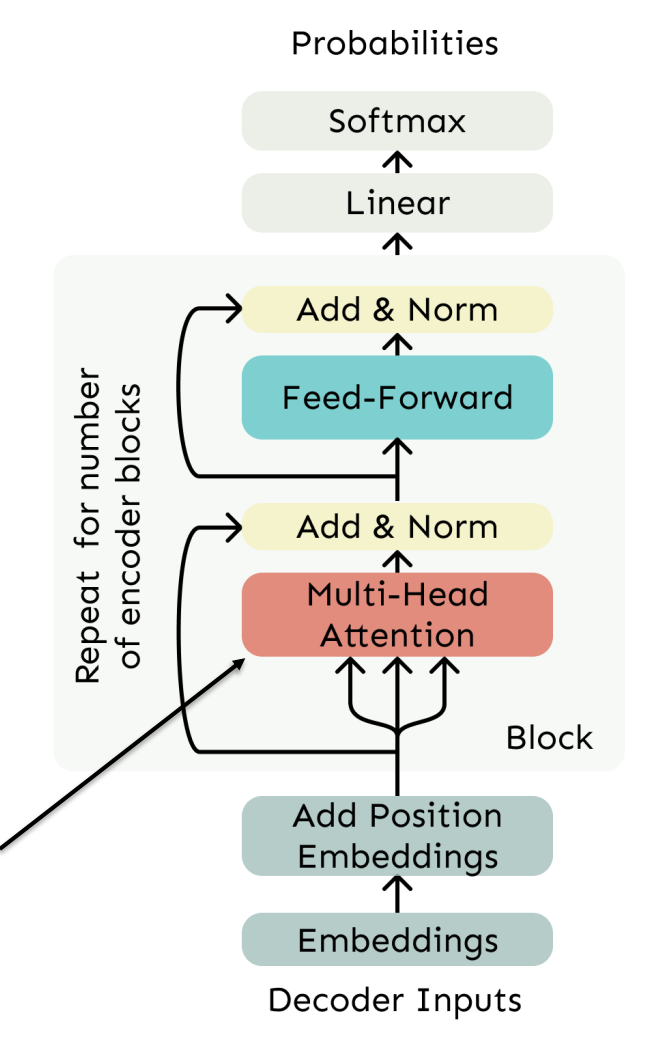
No Masking!
BERT
Encoder
Decoder
GPT
Encoder-Decoder
?
Pretrained Encoder-Decoder Model
Pretrained Encoder-Decoder Model
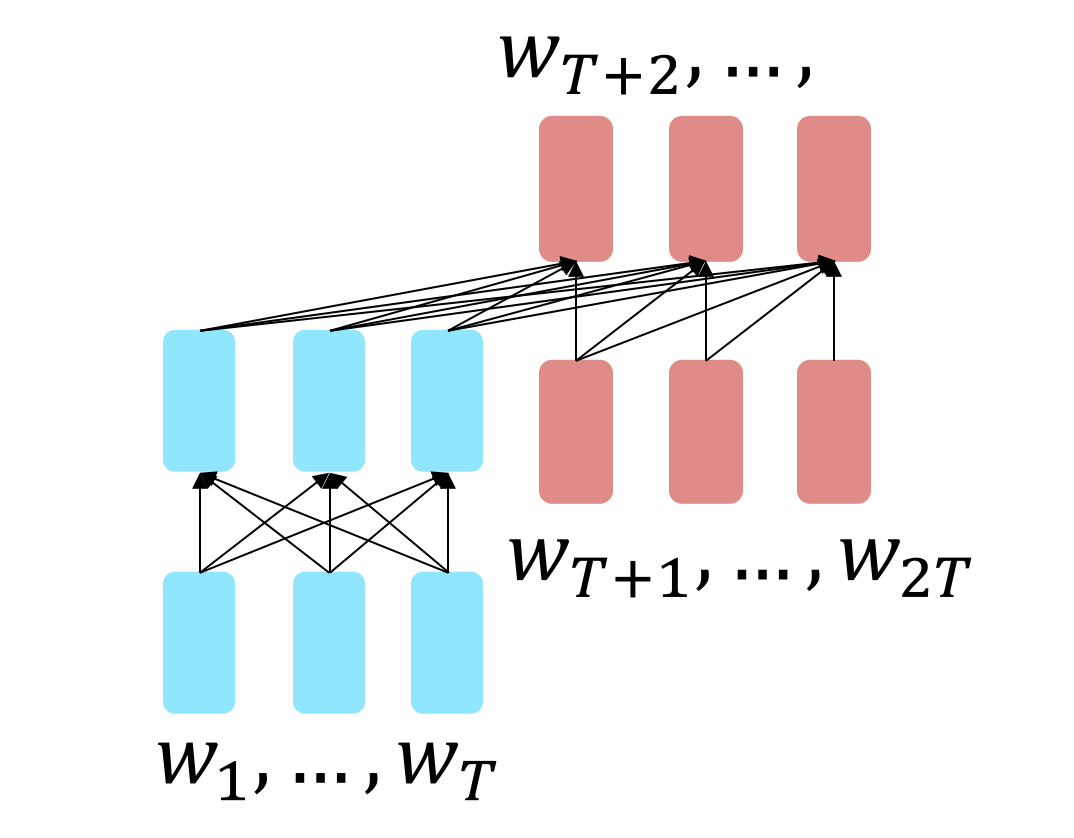
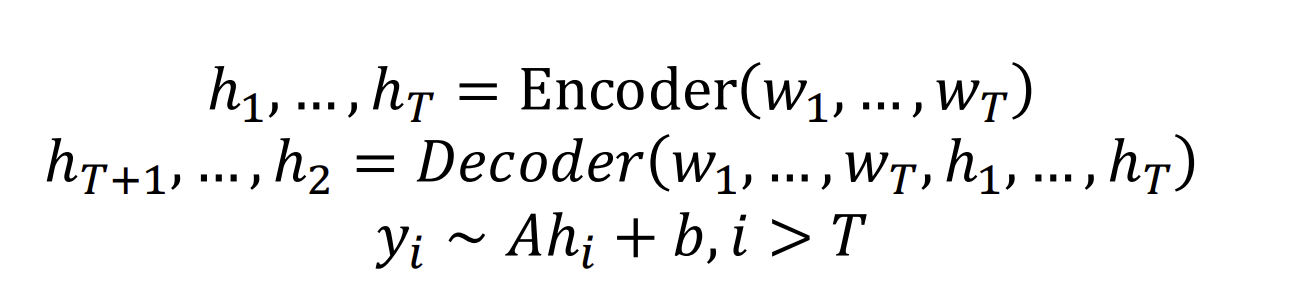
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
Prefix Language Model
Prefix Language Model
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
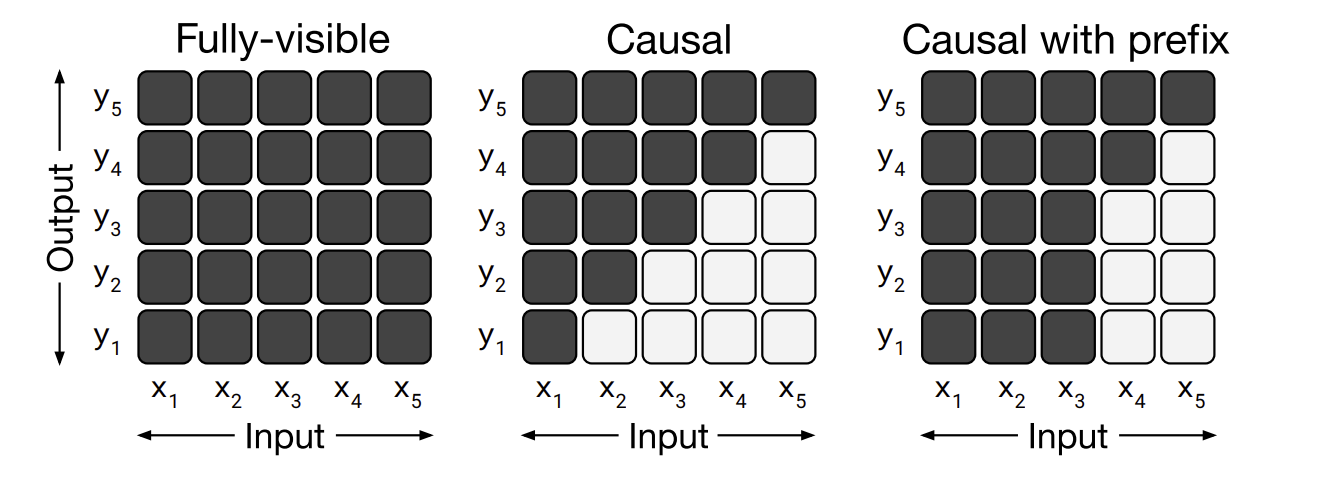
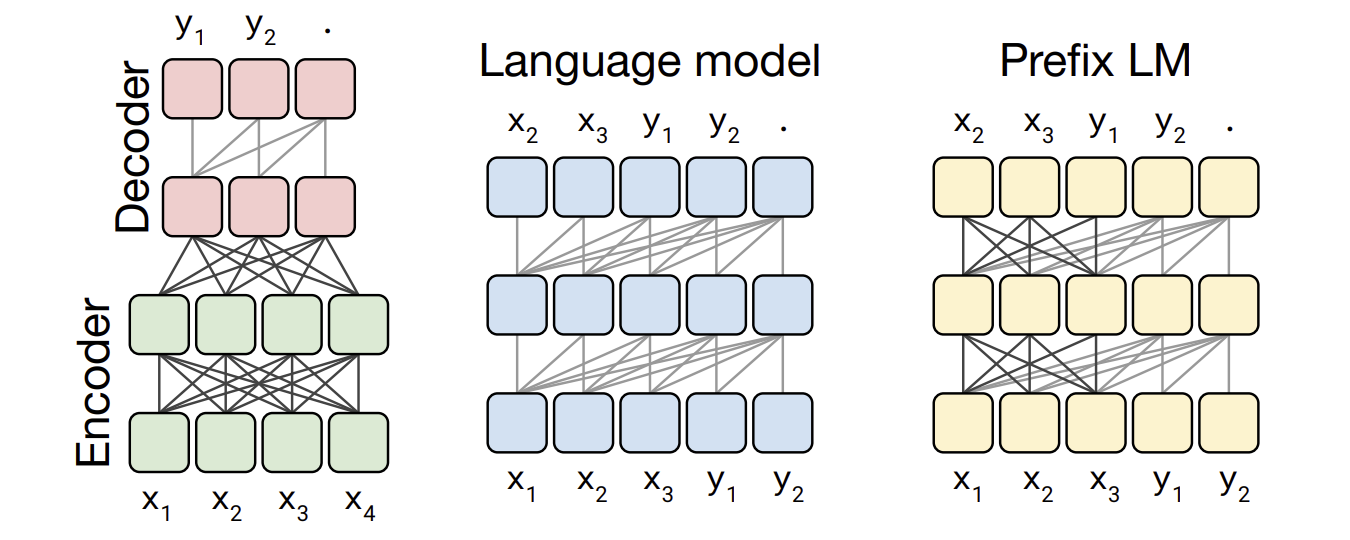
Why Encoder-Decoder Denoising Model
Why Encoder-Decoder Denoising Model
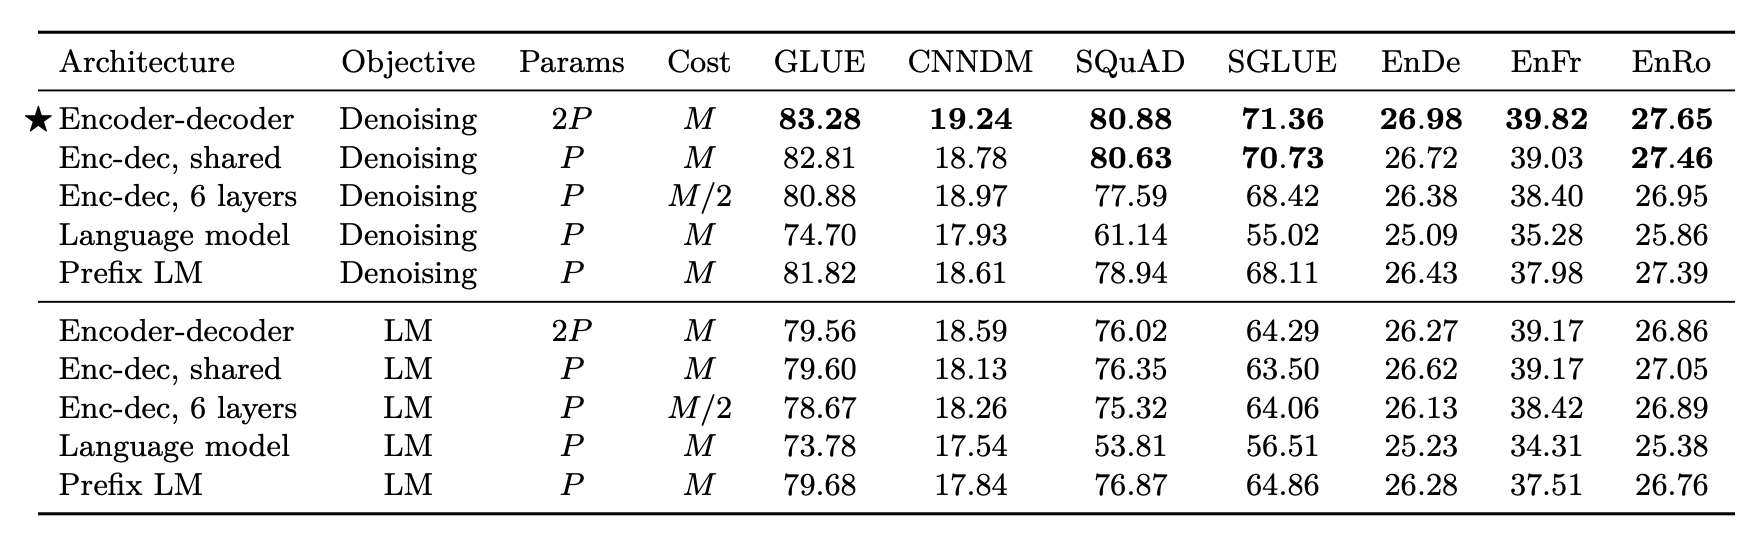
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
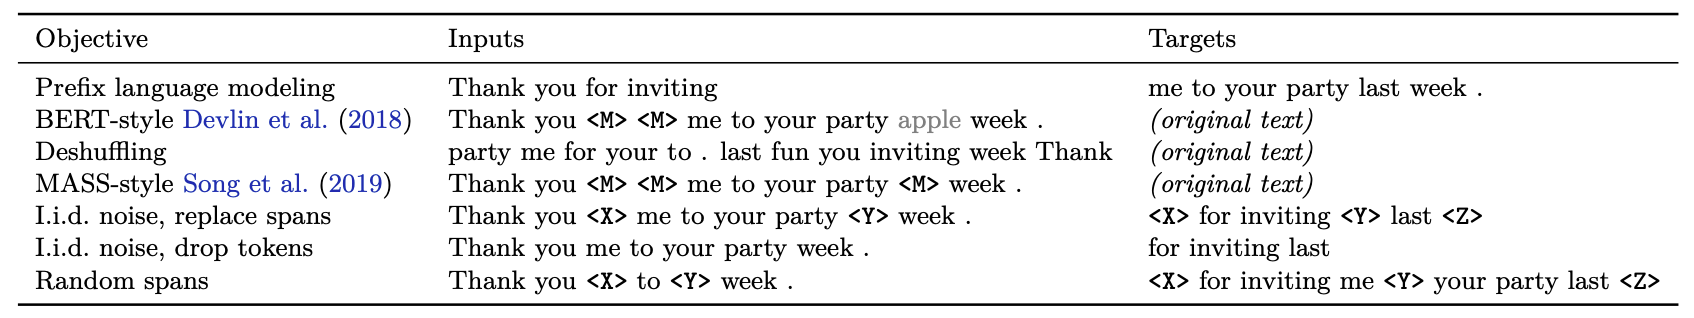
What is the Pretraining Output?
What is the Pretraining Output?
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
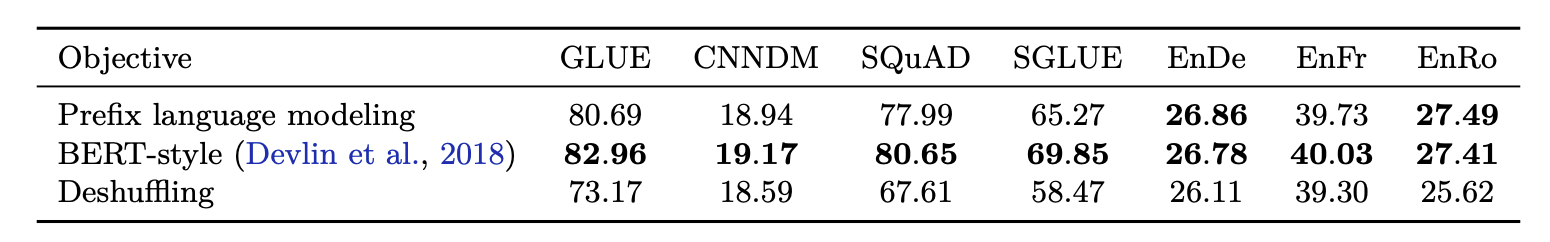
Choose Which One?
Choose Which One?
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
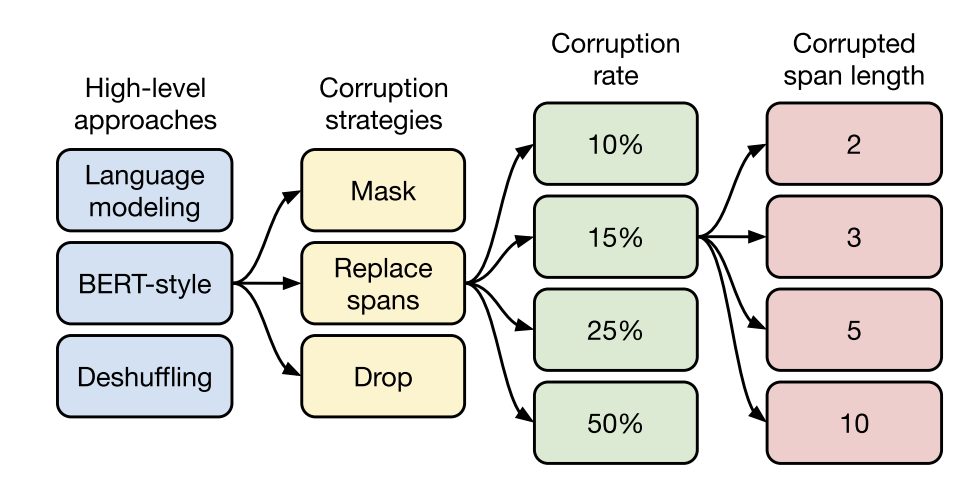
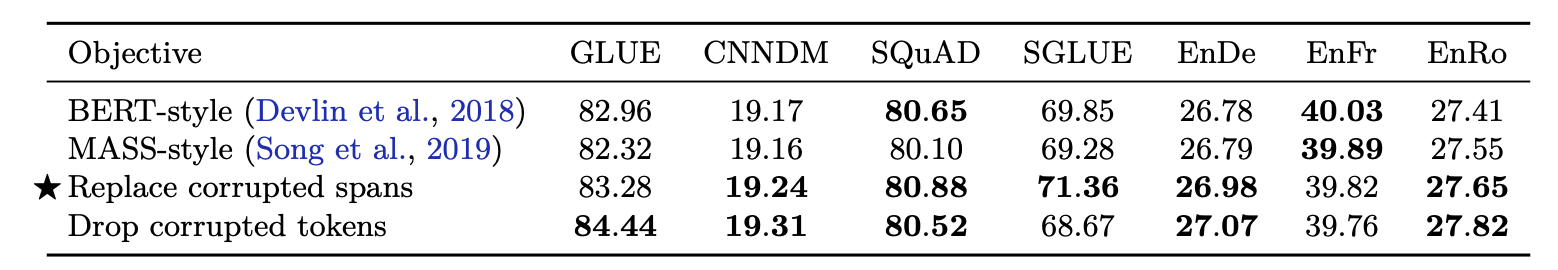
Choose Which One?
Choose Which One?
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
T5 (Text-to-Text Transfer Transformer, Google, 2021)
T5 (Text-to-Text Transfer Transformer, Google, 2021)
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
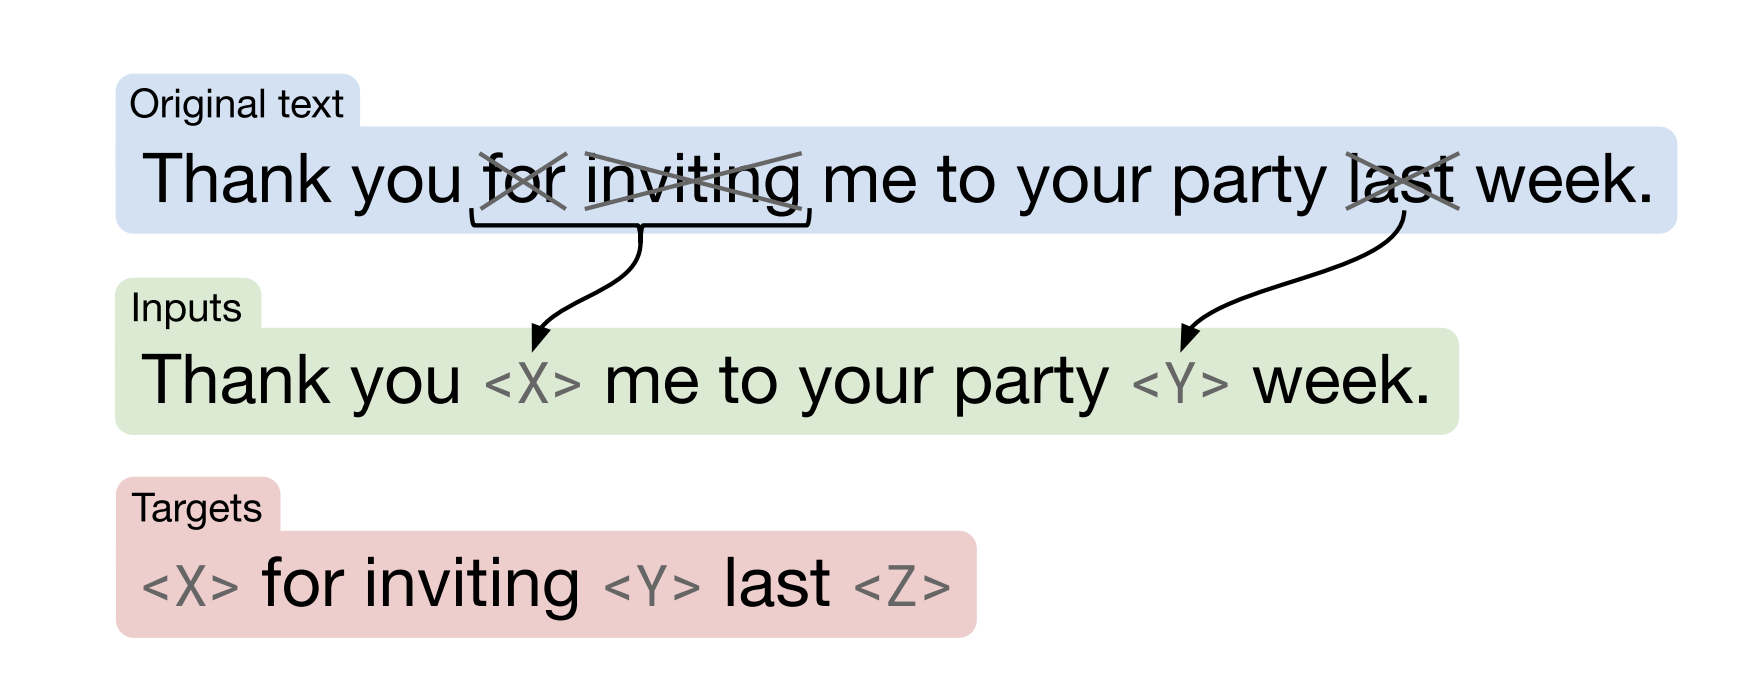
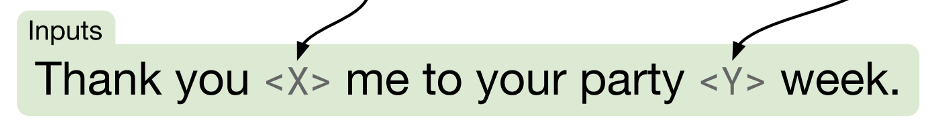
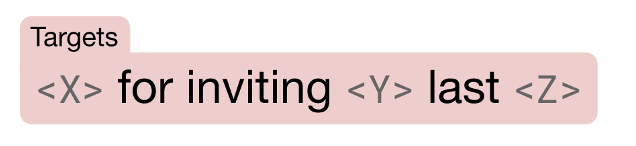
Uses a “span corruption” objective, where spans of text are randomly masked out and replaced by a mask token.
The model then must reconstruct these masked spans from the unmasked text.
Encoder-Decoder Framework
Multi-Task Pretraining
Multi-Task Pretraining
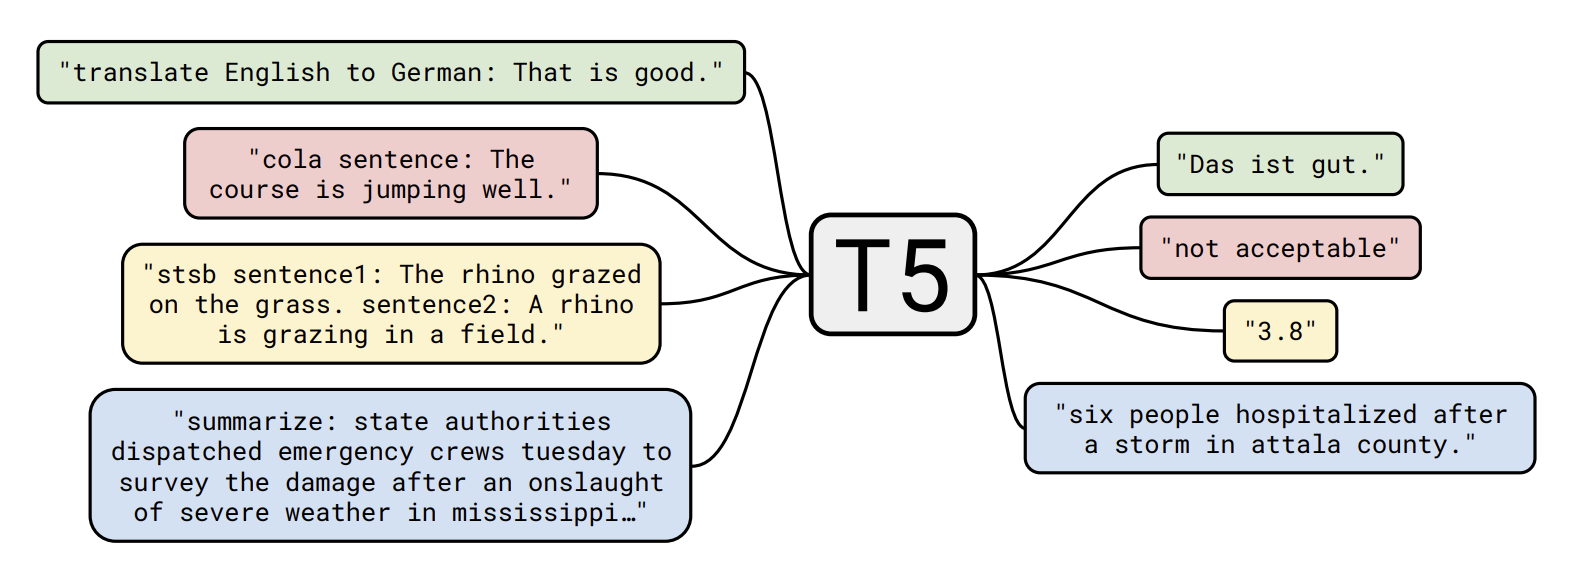
T5 converts every task into a text-in → text-out format. For example:
Sentiment classification:
Input: "sst2 sentence: I liked the movie.”
Output: "positive”
Summarization:
Input: "summarize: [article text]”
Output: "[short summary]”
Translation:
Input: "translate English to German: How are you?”
Output: "Wie geht es dir?"
By unifying all tasks under this text-to-text scheme, T5 uses the same encoder-decoder architecture and the same loss function for everything, rather than having specialized heads for classification, QA, etc.
T5: Inspiration of AGI
T5: Inspiration of AGI
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer, JMLR, 2020
2.3 Pretrained Language Models 2.3.6 Pretrained Model Gallery
2.3 Pretrained Language Models 2.3.6 Pretrained Model Gallery
ULMFiT (2018)
ULMFiT (2018)
What:
Another pretrain–fine-tune architecture for NLP using LSTM-based language models at the same time with ELMO.
Why it’s important:
Historical significance: demonstrated that language model fine-tuning can drastically improve downstream tasks.
Bridges older RNN-based approaches and modern transformer-based methods.
RoBERTa (2019)
RoBERTa (2019)
What:
A robustly optimized BERT variant from Facebook (Meta AI) that removes Next Sentence Prediction (NSP) and trains with longer sequences, dynamic masking, and more data.
Why it’s important:
Demonstrates that improved training protocols can yield better performance without architectural changes.
One of the first to show NSP might not be crucial in BERT-like models.
SpanBERT (2019)
SpanBERT (2019)
What:
A variant of BERT that masks and predicts contiguous spans of text rather than individual tokens.
Why it’s important:
By focusing on phrase-level (span-level) context, SpanBERT better captures how multiple tokens interact to form entities or expressions.
This improvement leads to better performance on tasks such as question answering, coreference resolution, and information extraction—where understanding multi-token entities is crucial.
XLNet (2019)
XLNet (2019)
What:
A generalized auto-regressive pretraining method that uses permutation language modeling rather than strictly left-to-right or masked token prediction.
Why it’s important:
Addresses some of the limitations of BERT’s masked language modeling by learning bidirectional context while still using an auto-regressive objective.
Showed strong performance on a variety of NLP benchmarks at the time.
BART (2019)
BART (2019)
What:
An encoder-decoder (seq2seq) model that corrupts text input (via masking, shuffling, etc.) and learns to reconstruct the original text.
Why it’s important:
Demonstrates a strong denoising autoencoder approach for generation tasks (summarization, etc.).
Similar architecture to T5 but with different corruption strategies.
MASS (2019)
MASS (2019)
What:
An encoder-decoder model that masks a fragment of the input and trains the decoder to reconstruct it.
Why it’s important:
Early encoder-decoder approach for tasks like machine translation.
A direct precursor to frameworks like BART/T5 in seq2seq pretraining.
ALBERT (2019)
ALBERT (2019)
What:
A “lite” version of BERT that uses parameter-sharing across layers and factorized embeddings to reduce the model size.
Why it’s important:
Illustrates parameter efficiency in large Transformers.
Achieves near-state-of-the-art performance at the time with far fewer parameters.
DistilBERT (2019)
DistilBERT (2019)
What:
A distilled (smaller) version of BERT that retains much of its performance while being faster and lighter.
Why it’s important:
Showcases knowledge distillation for compressing large PLMs.
Vital for real-world deployment constraints (latency, memory).
XLM/mBERT/XLM-R (2019)
XLM/mBERT/XLM-R (2019)
What:
Multilingual and cross-lingual variants of BERT-like models.
Why it’s important:
Demonstrates how to handle many languages within a single model.
Cross-lingual transfer (fine-tune in one language, apply to another).
2.3 Pretrained Language Models 2.3.7 Suggested Readings
2.3 Pretrained Language Models 2.3.7 Suggested Readings
Papers and Articles
Papers and Articles
Improving Language Understanding by Generative Pre-Training https://cdn.openai.com/research-covers/language-unsupervised/language_understanding_paper.pdf
BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding https://aclanthology.org/N19-1423/
Exploring the Limits of Transfer Learning with a Unified Text-to-Text Transformer: https://jmlr.org/papers/v21/20-074.html
Any Questions?
Any Questions?