Natural Language UnderstandingLarge Language Model
Natural Language
Understanding
Large Language Model
Understanding
Large Language Model
Mingming Sun
BIMSA
Outline
Outline
Large Language Model
Pretraining
Supervised Instruction Finetuning
Reinforcement Learning from Human Preference
2.5 Large Language Models 2.5.1 Pretraining
2.5 Large Language Models 2.5.1 Pretraining
Pretraining
Pretraining
Definition: Pretraining refers to the process of training a language model on a large corpus of raw text using self-supervised learning.
Objective: Learn statistical patterns of language, including grammar, semantics, and world knowledge.
Output: A general-purpose model that can be adapted (via fine-tuning or prompting) to downstream tasks.
Recall: Pretrained Language Model
Recall: Pretrained Language Model
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture09-pretraining.pdf
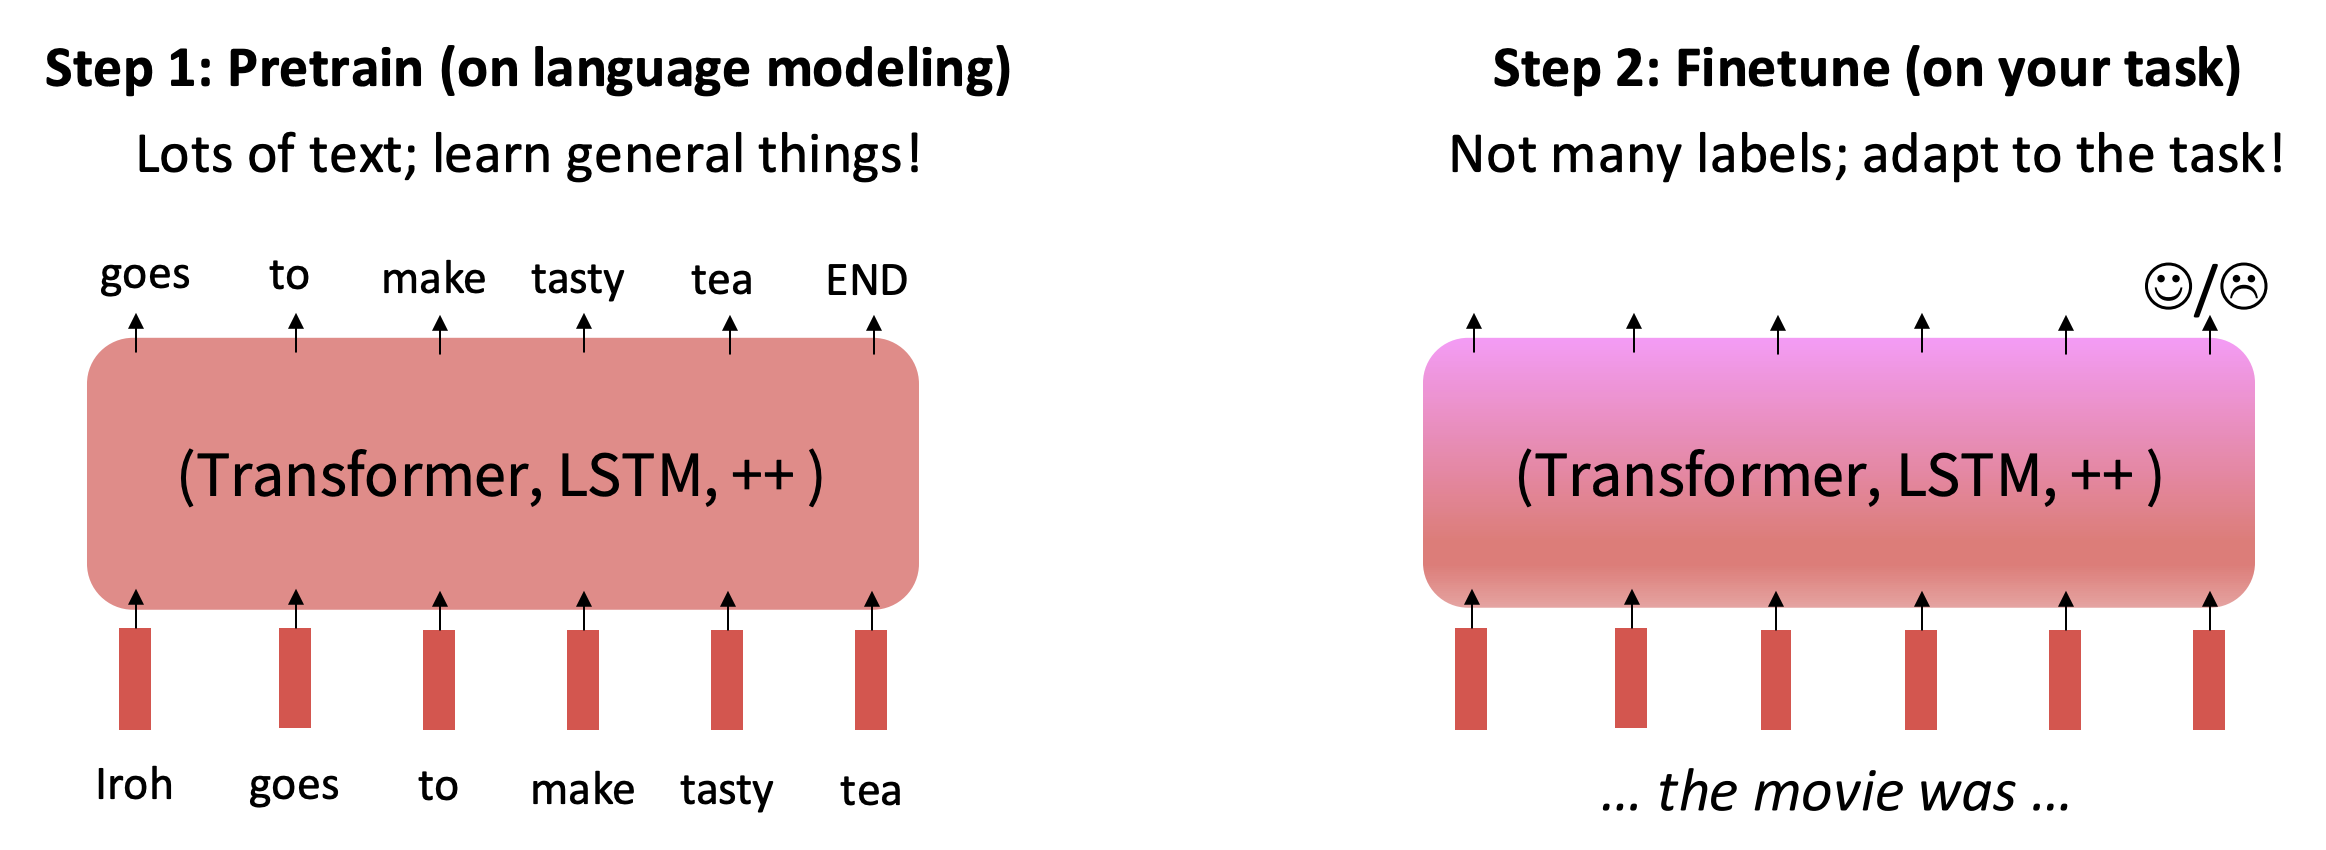
Recall: Pretrained Language Model
Recall: Pretrained Language Model
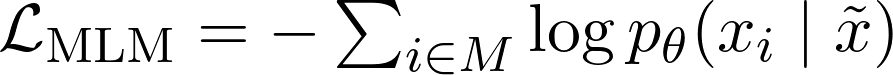
Language Model:
Masked Language Model:
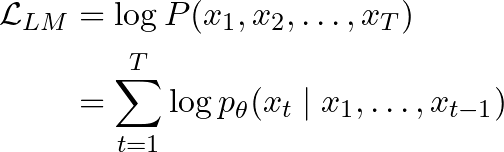
Recall: Pretrained Language Model
Recall: Pretrained Language Model
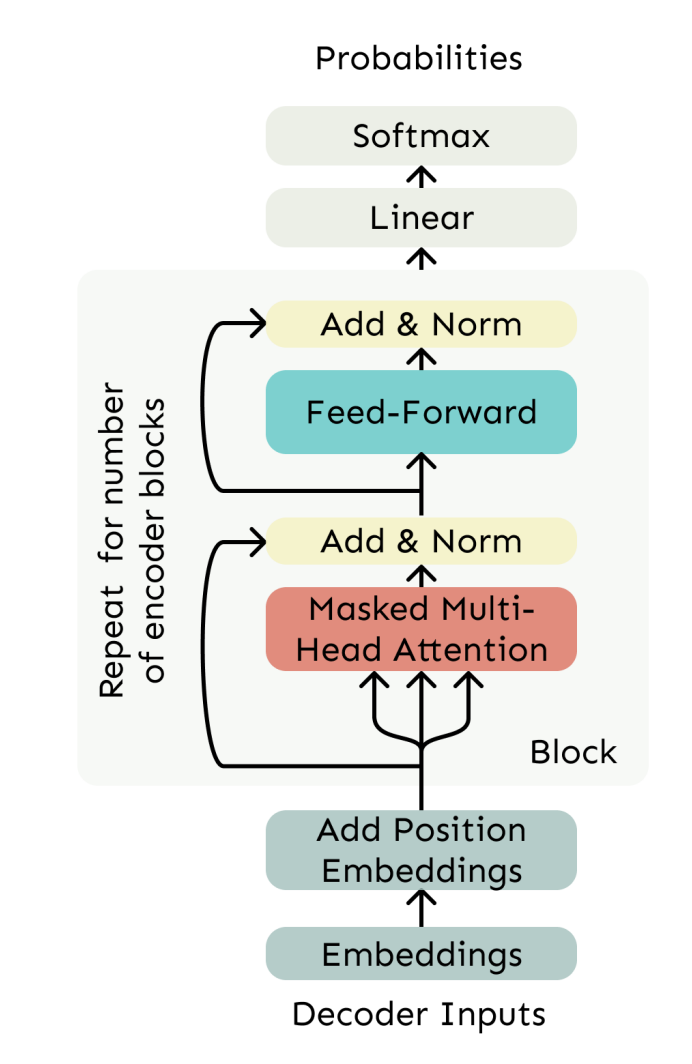
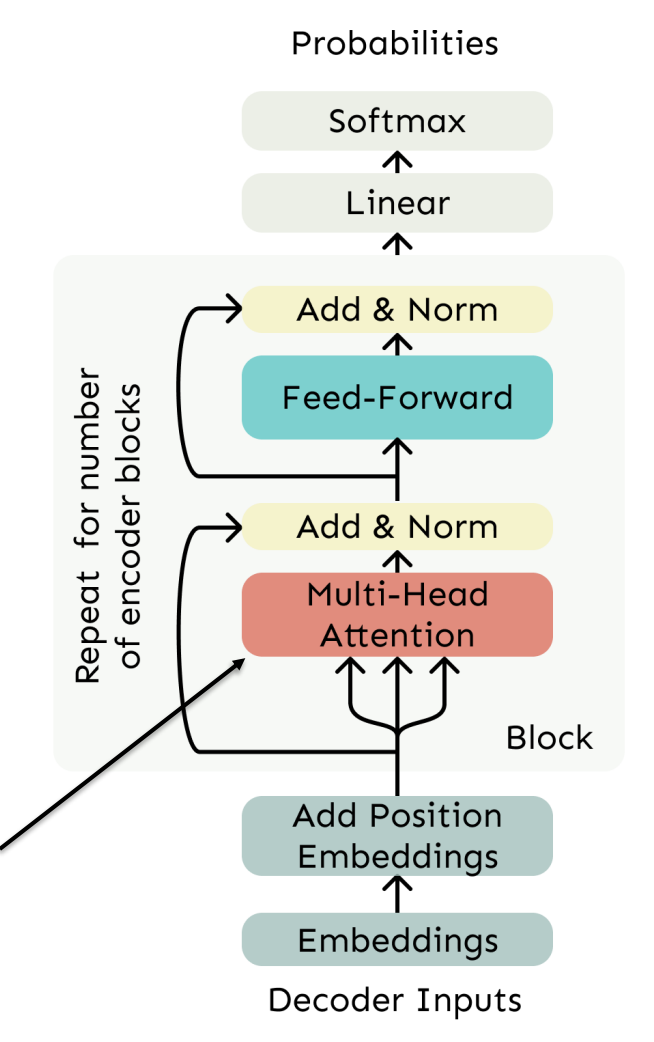
No Masking!
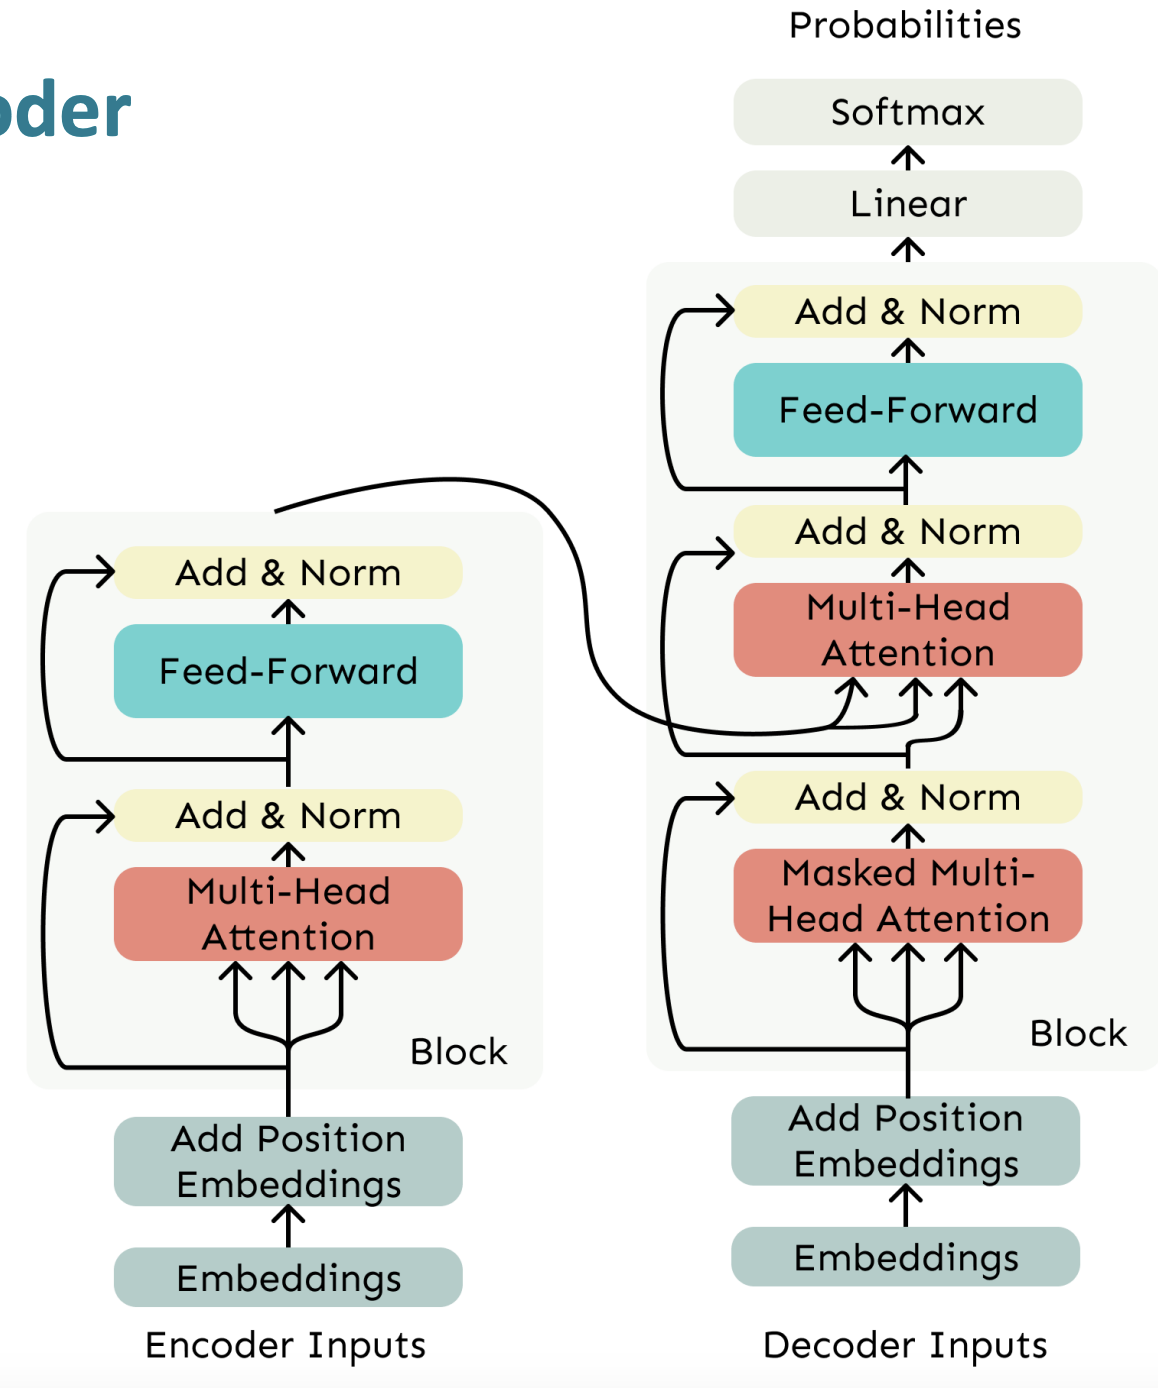
BERT
Encoder
Decoder
GPT
Encoder-Decoder
Bart, T5
Why Large Pretrained Language Model?
Why Large Pretrained Language Model?
Pretrained Language Model:
Trained on mid-sized datasets with mid-sized models
Require fine-tuning for specific tasks (e.g., classification, QA)
Limited generalization: perform well on tasks they are tuned for
Do not exhibit general language understanding
Example: BERT, GPT-2, T5
Why Large Pretrained Language Model?
Why Large Pretrained Language Model?
Large Pretrained Language Model:
Trained on massive datasets with billions of parameters
Surprising capabilities emerge during pretraining
Demonstrate general language understanding (though imperfect)
Able to perform zero-shot, few-shot, and chain-of-thought reasoning
Represent a new paradigm in language understanding
Example: GPT-3, PaLM, LLaMA, GPT-4
Why Large Pretrained Language Model?
Why Large Pretrained Language Model?
Capability | PLM (Early Models) | LLM (Modern Models) |
Model Size | ~100M – 1B parameters | 10B – 500B+ parameters |
Training Data | Mid-sized, domain-limited | Diverse, web-scale corpora |
Task Generalization | Weak, narrow | Strong, task-agnostic |
Emergent Abilities | ✘ None observed | ✔ Appear with scale |
Language Understanding | Task-specific pattern matching | Signs of general competence |
GPT3: The Beginning of Large Pretrained Language Model
GPT3: The Beginning of Large Pretrained Language Model
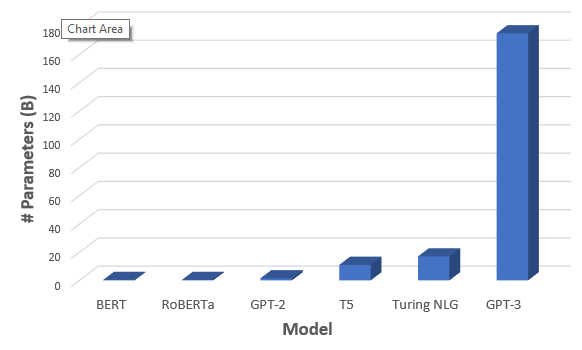
https://blog.accubits.com/getting-started-with-gpt-3-model-by-openai/
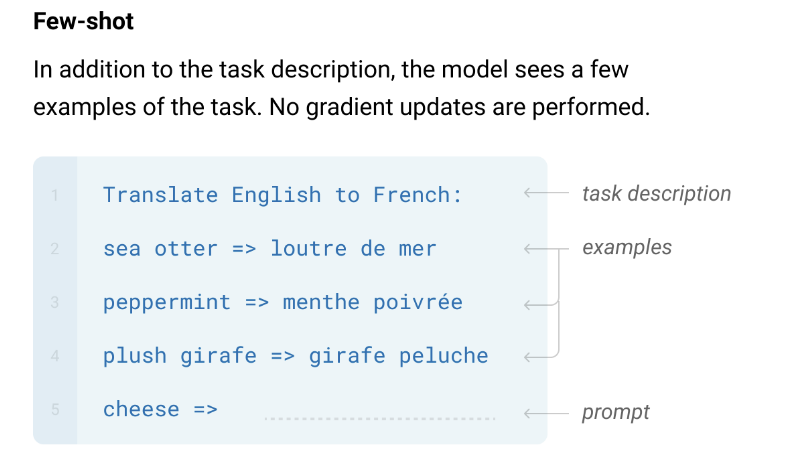
Few-Shot In-Context Learning
Few-Shot In-Context Learning
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
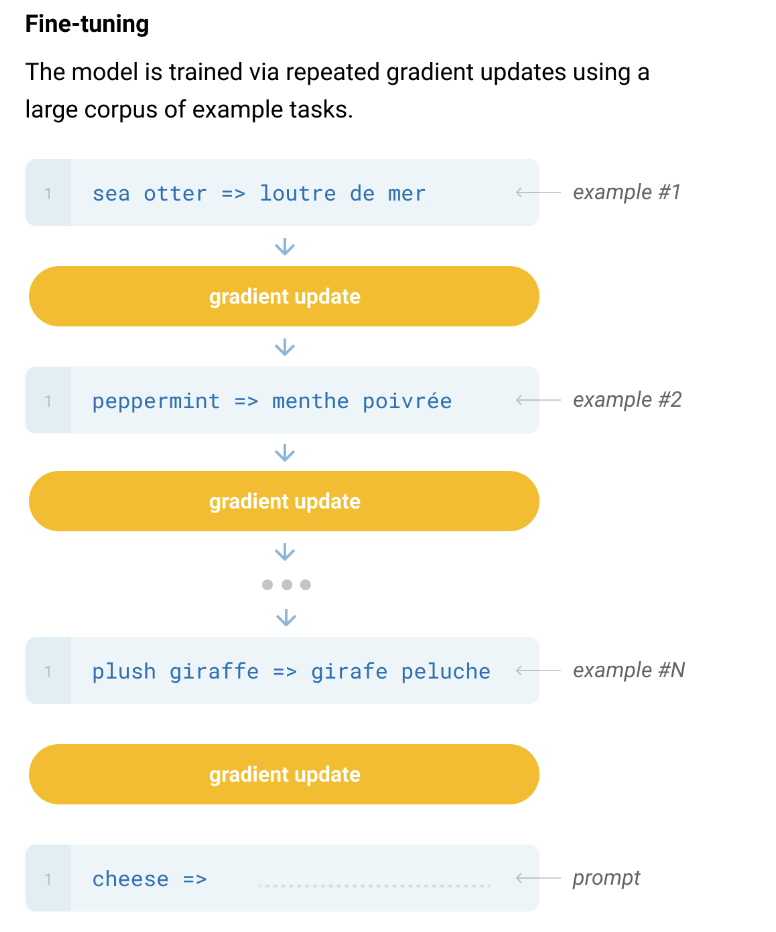
Machine Translation Task
Traditional Fine-tuning Approach →
Let‘s see Few shot In-Context Learning Approach by GPT 3
Few Shot In-Context Learning
Few Shot In-Context Learning
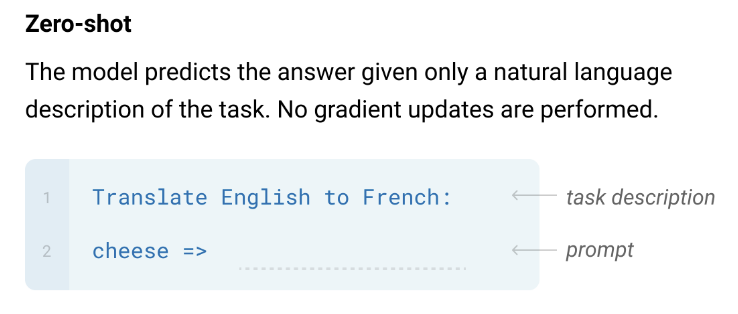
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
Few Shot In-Context Learning
Few Shot In-Context Learning
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
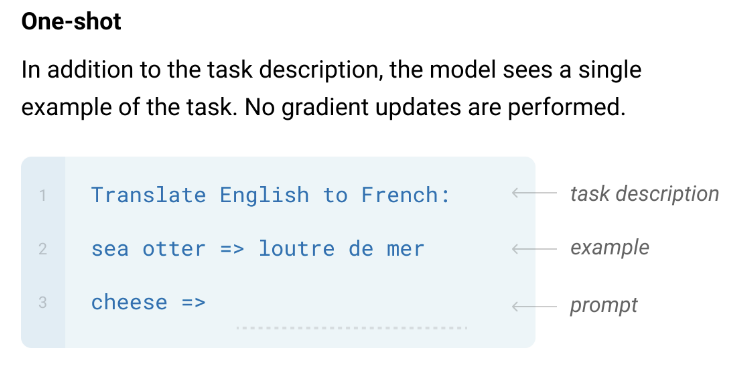
Few Shot In-Context Learning
Few Shot In-Context Learning
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
More Examples
More Examples
Sentiment analysis
Classify the sentiment of each sentence as Positive, Negative, or Neutral.
"I love this movie!" → Positive
"This is the worst product I've ever bought." → Negative
"It's an average experience." → Neutral
"The customer service was excellent!" →
Math Word Problem
Solve the problem and write the answer as a number.
Q: If you have 5 apples and you give away 2, how many are left?
A: 3
Q: John has 12 pencils. He buys 5 more. How many pencils does he have now?
A: 17
Q: Sarah read 7 books last month and 6 books this month. How many books did she read in total?
A:
Named Entity Recognition
Extract named entities and classify them as PERSON, LOCATION, or ORGANIZATION.
Sentence: "Barack Obama visited Paris."
Entities: Barack Obama [PERSON], Paris [LOCATION]
Sentence: "Google opened a new office in London."
Entities: Google [ORGANIZATION], London [LOCATION]
Sentence: "Elon Musk met with the mayor of New York."
Entities:
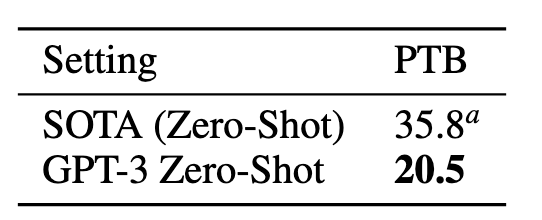
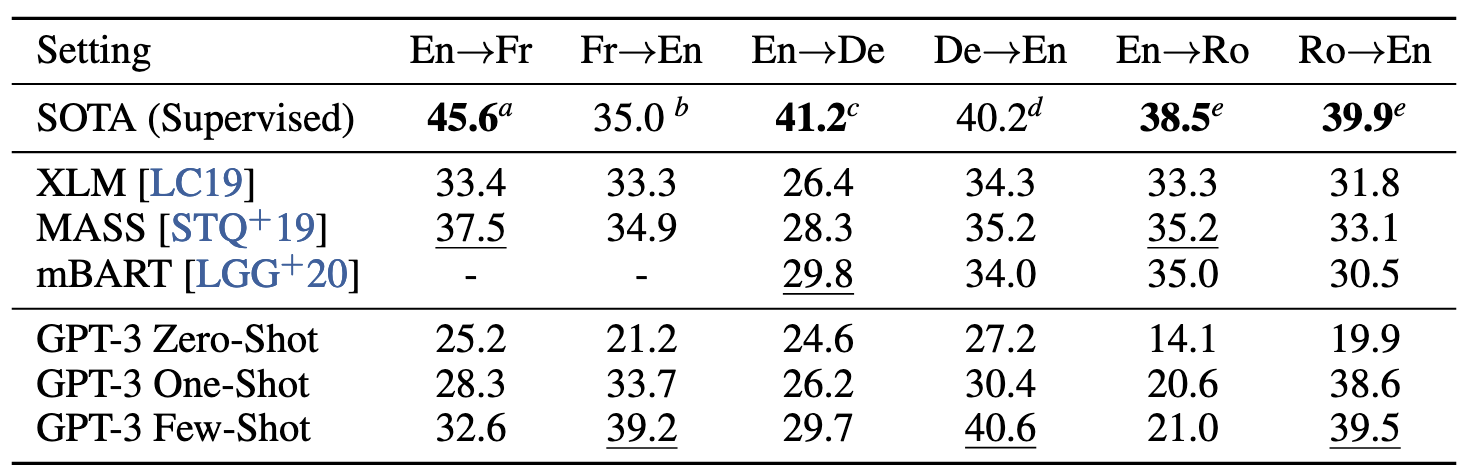
Performances
Performances
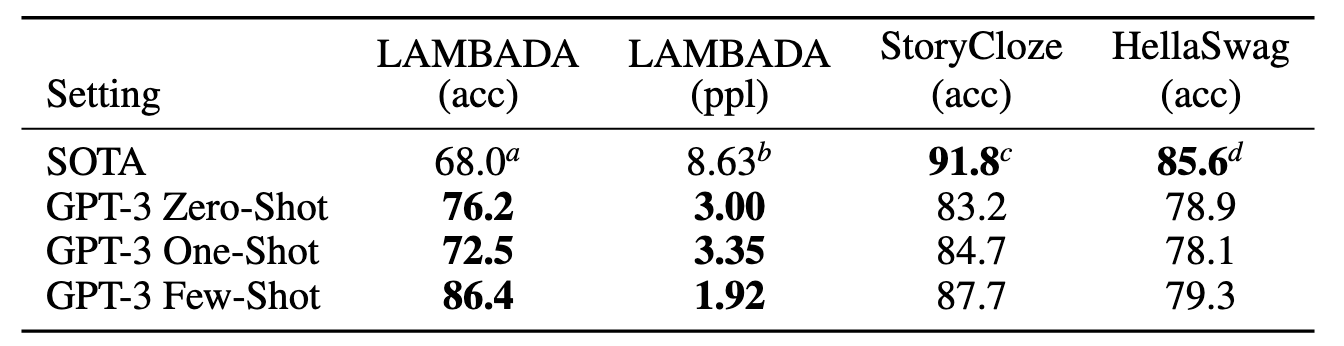
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
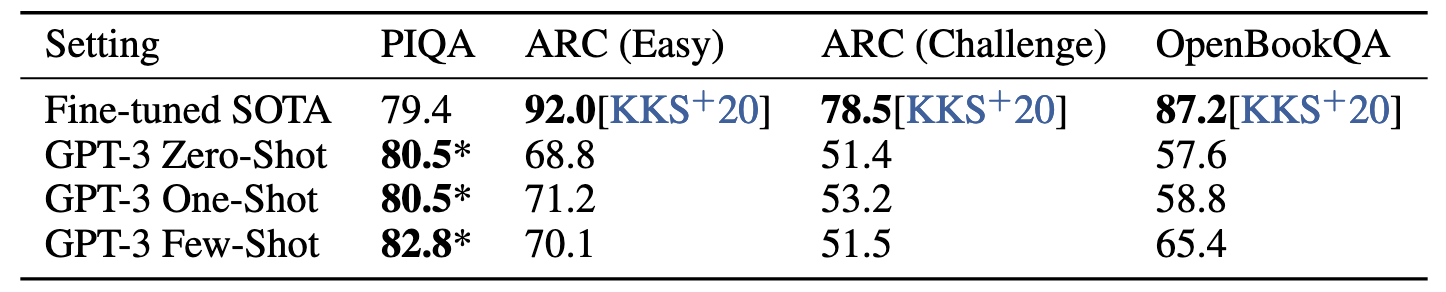
Where the Ability Comes From? Scaling Law
Where the Ability Comes From? Scaling Law
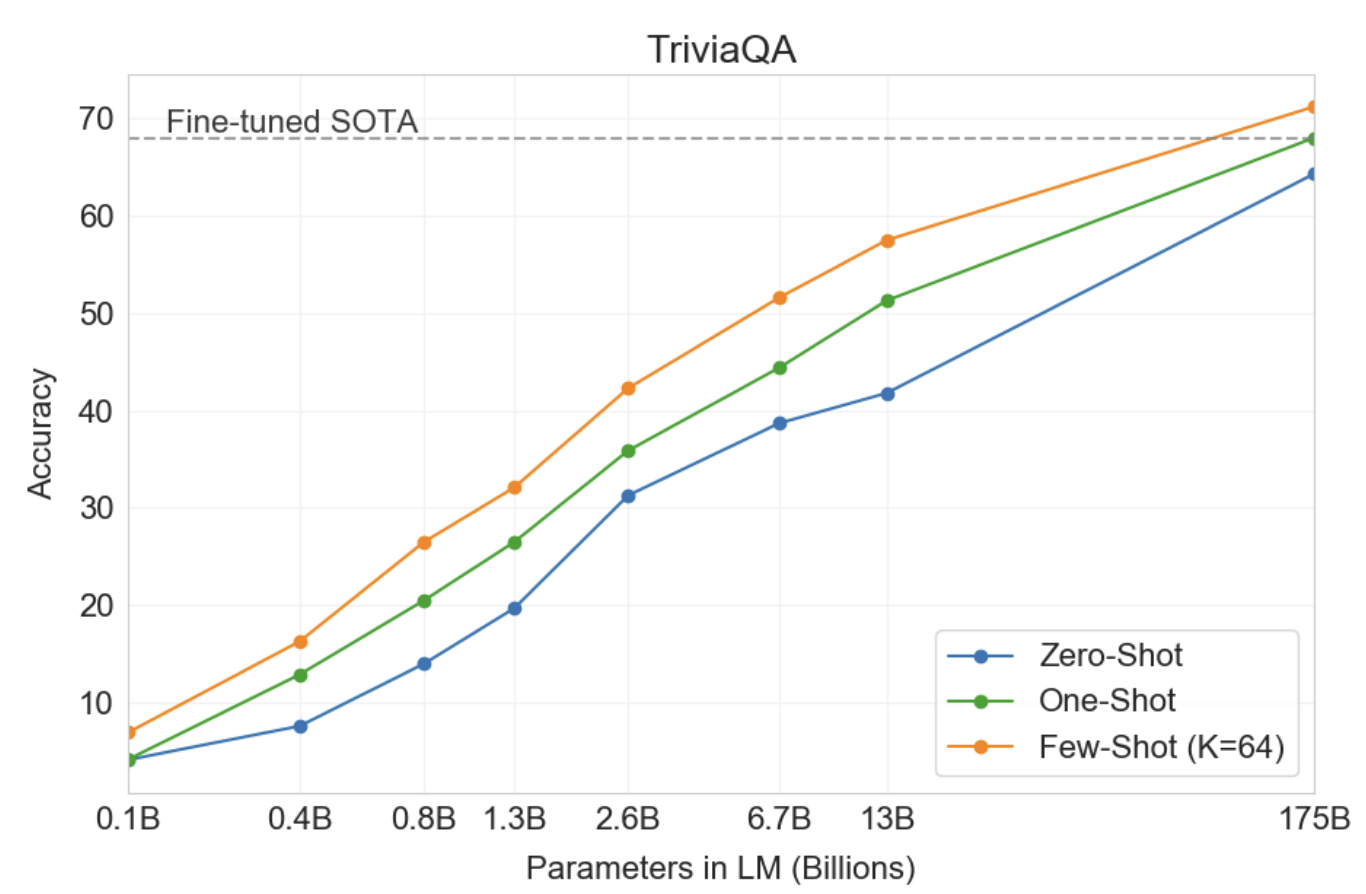
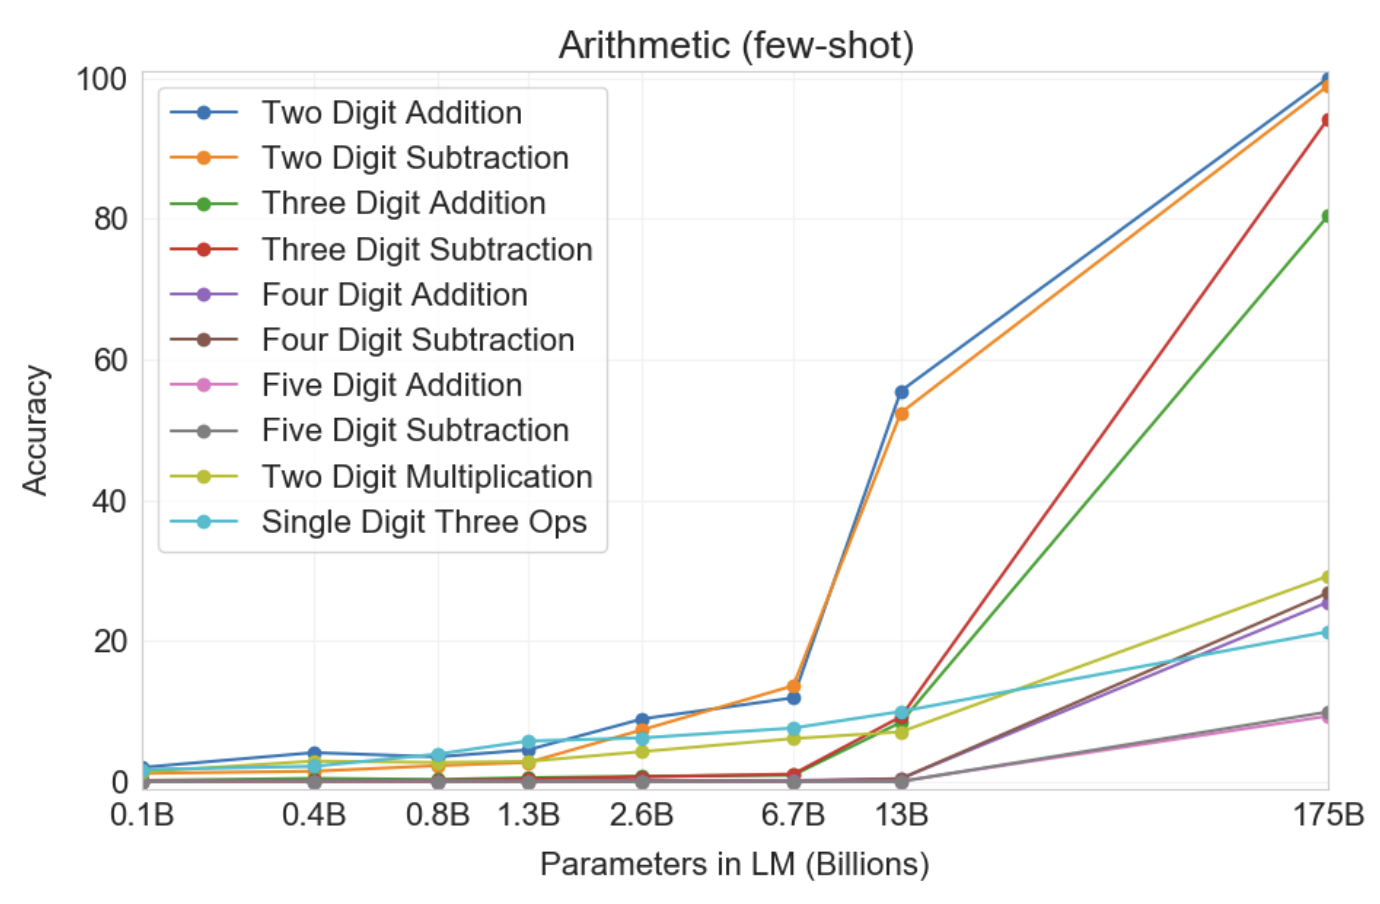
T. B. Brown, et.al , Language Models are Few-Shot Learners, 2020
Historical Discovery on Scaling
Historical Discovery on Scaling
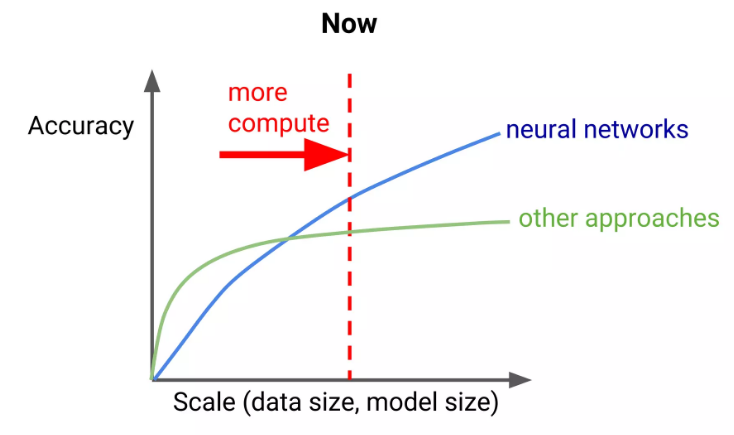
“Trends and Developments in Deep Learning Research” Jeff Dean, Google, 2017
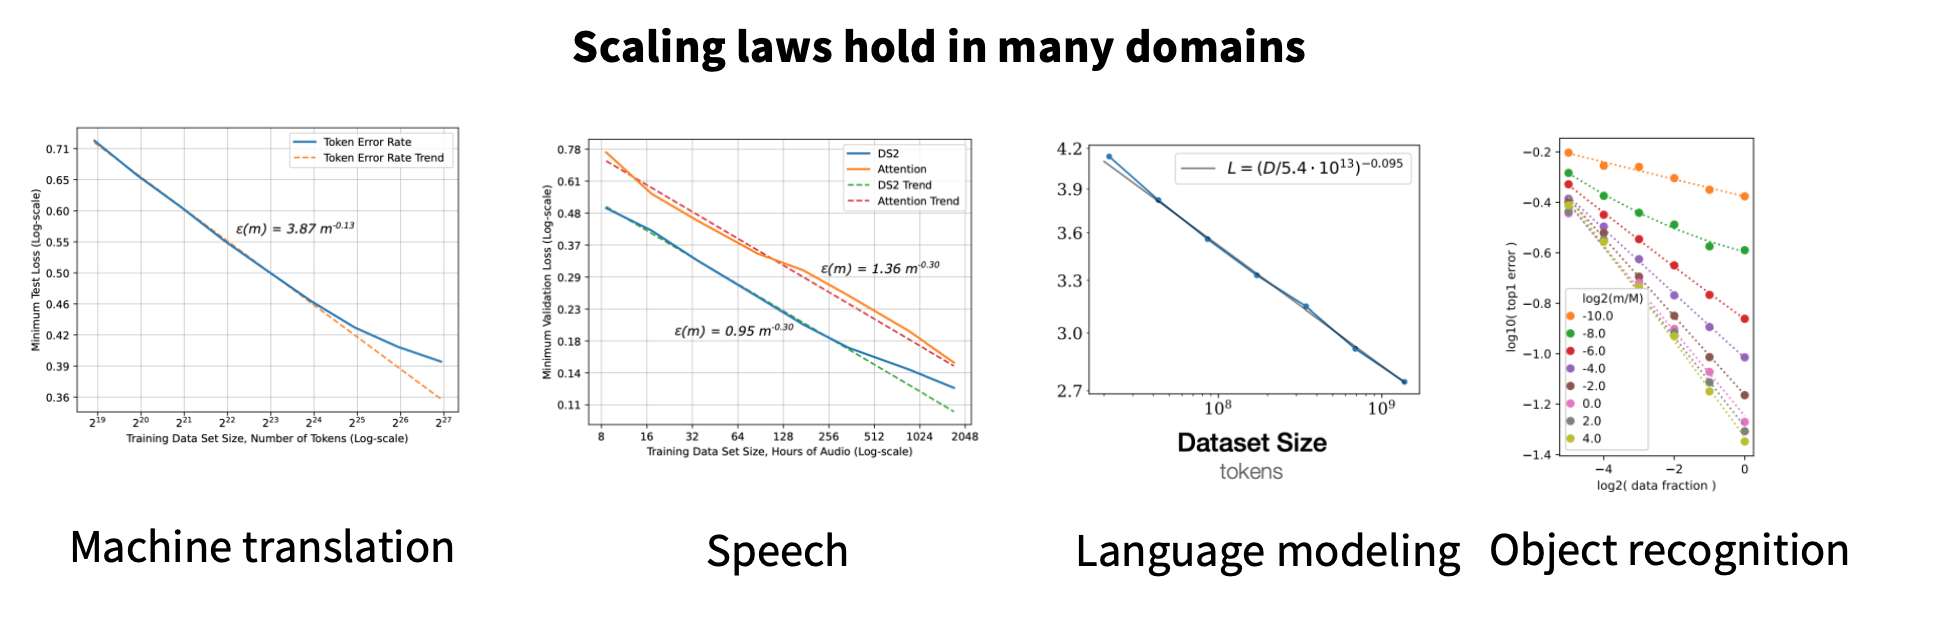
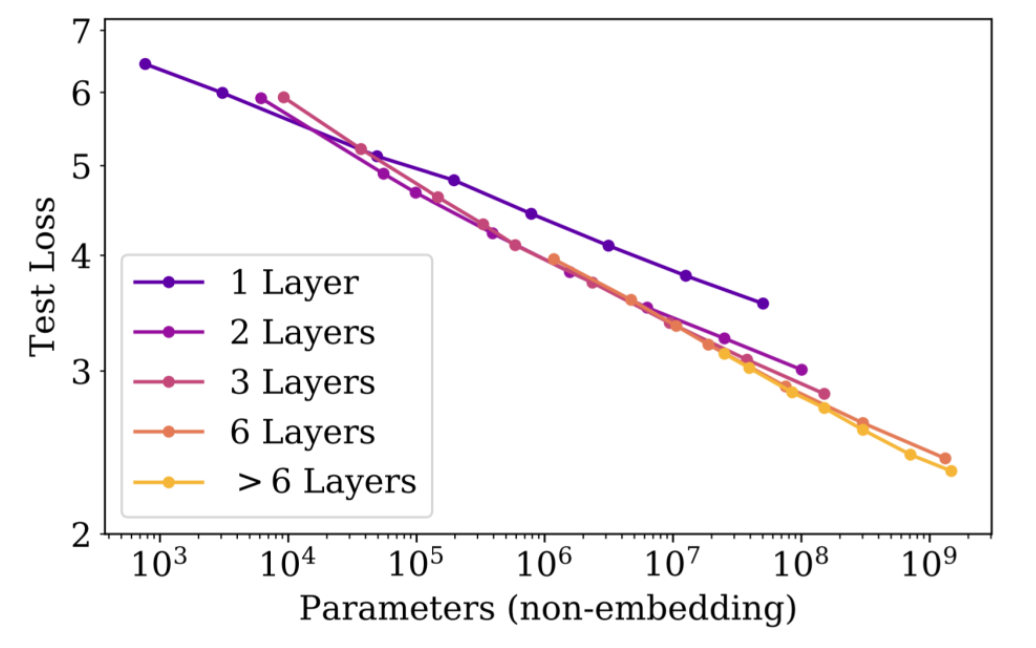
Scaling Law on LLM
Scaling Law on LLM
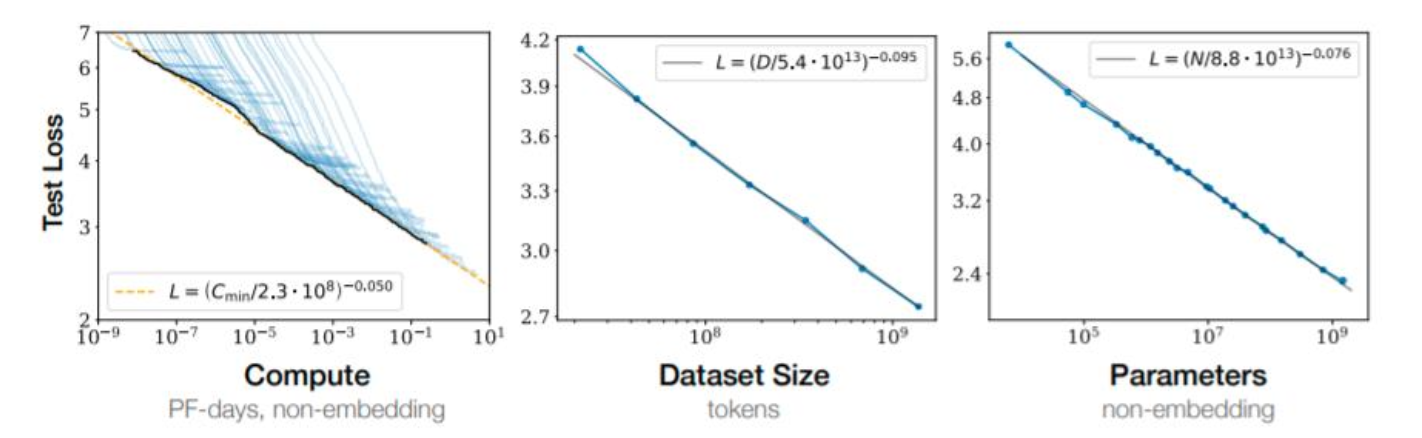
J. Kaplan, Scaling Laws for Neural Language Models, 2020
Scaling Law on LLM
Scaling Law on LLM
J. Kaplan, Scaling Laws for Neural Language Models, 2020
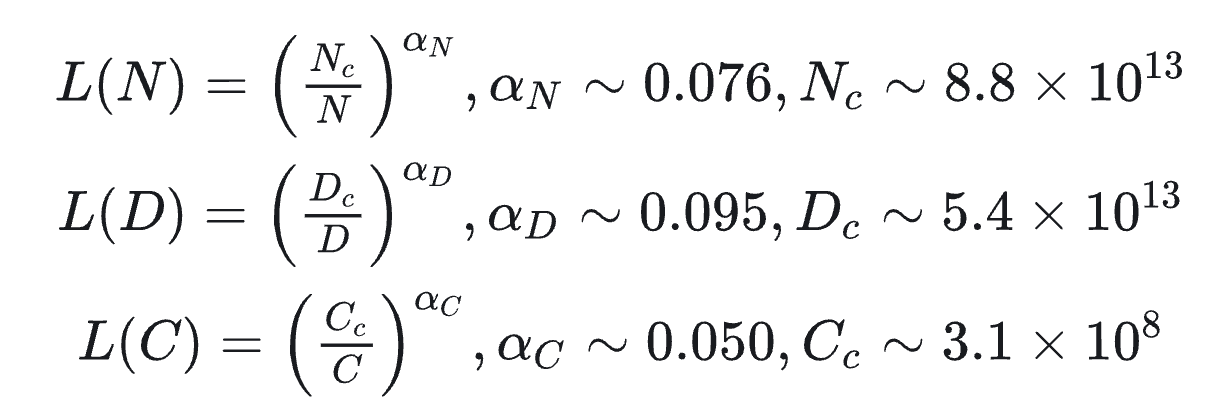
Data Scaling
Data Scaling
Statistical Learning
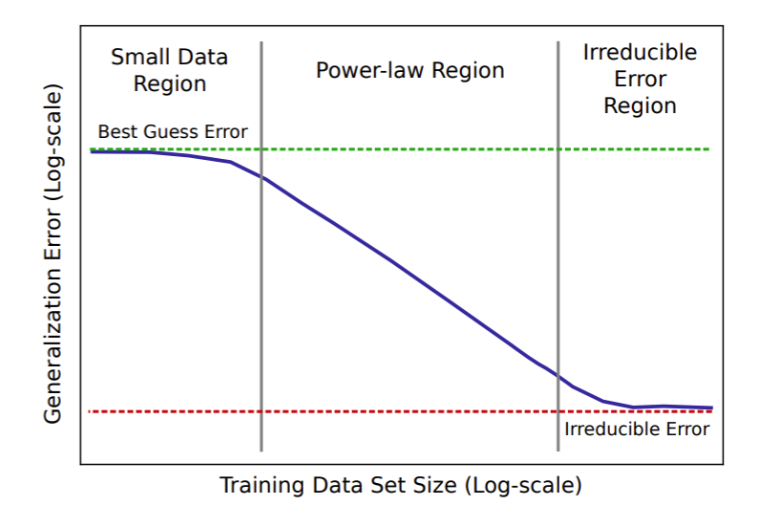
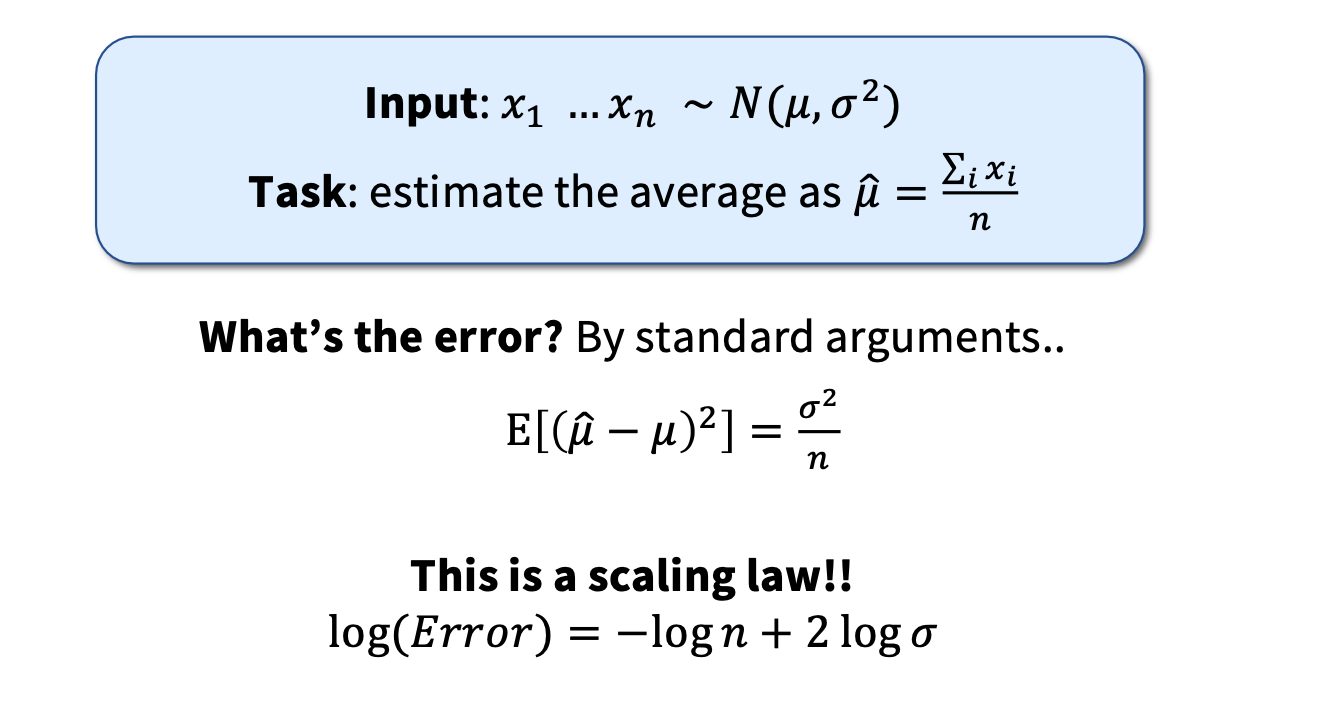
Scaling Laws for Nonparametric Learning
Scaling Laws for Nonparametric Learning
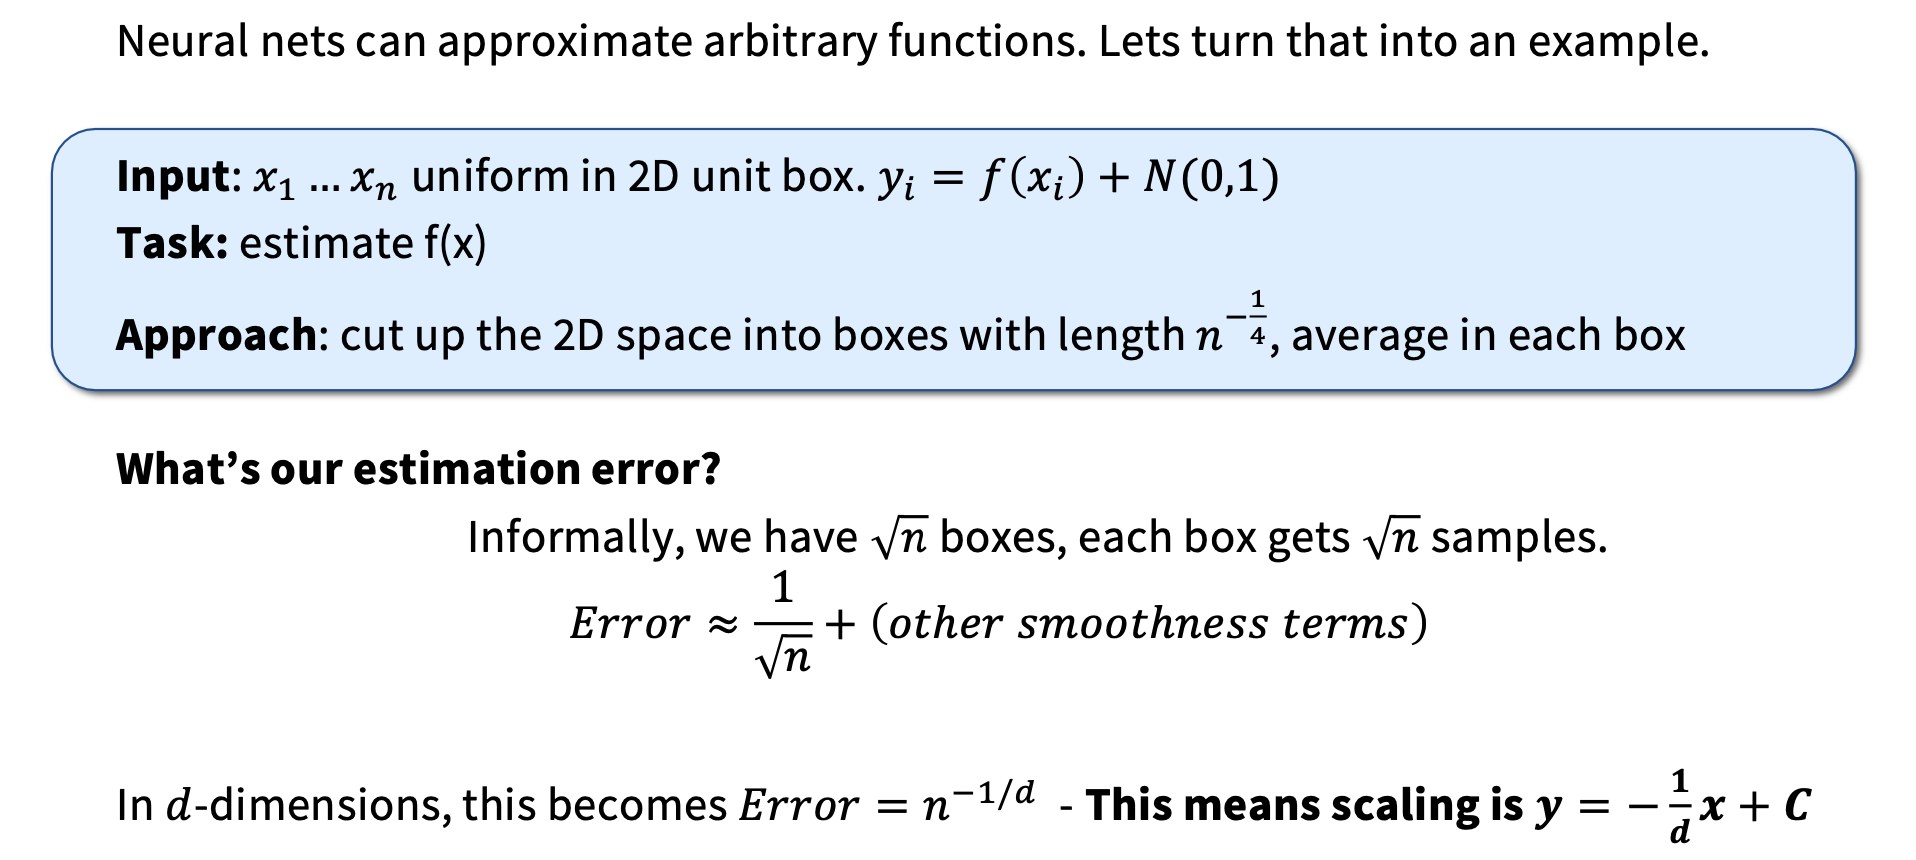
Model Scaling
Model Scaling
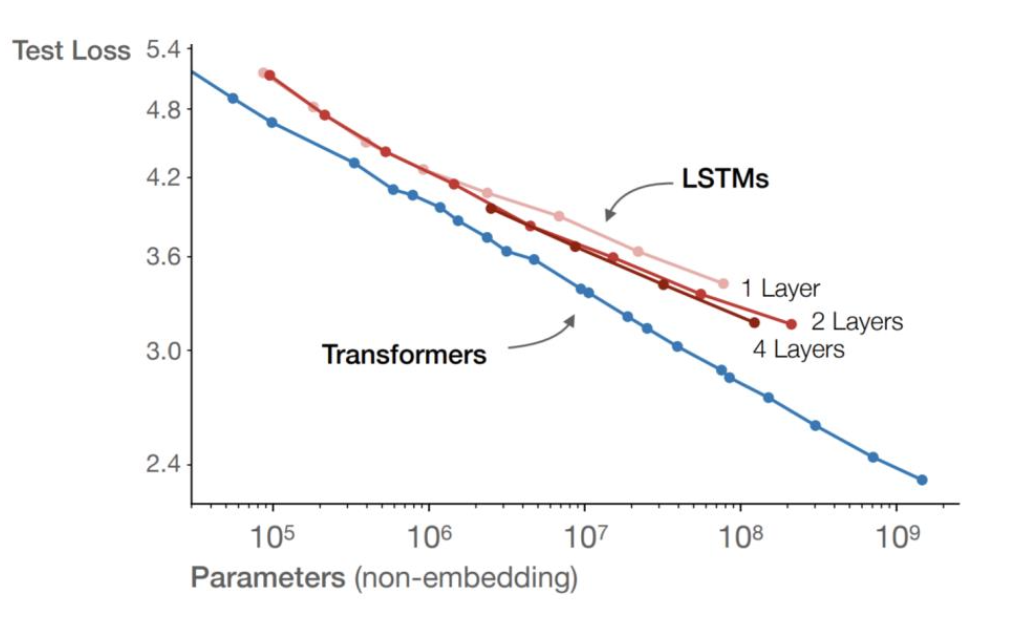
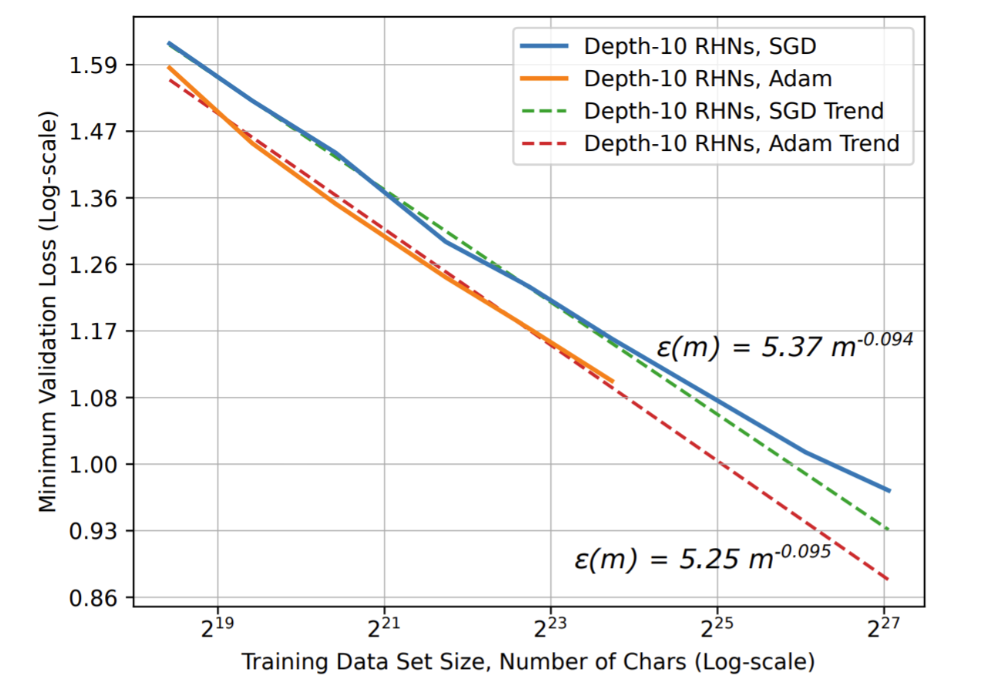
Data & Model Joint Scaling
Data & Model Joint Scaling
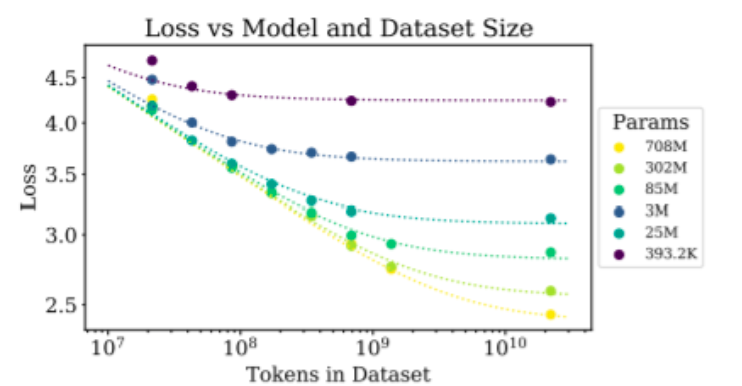
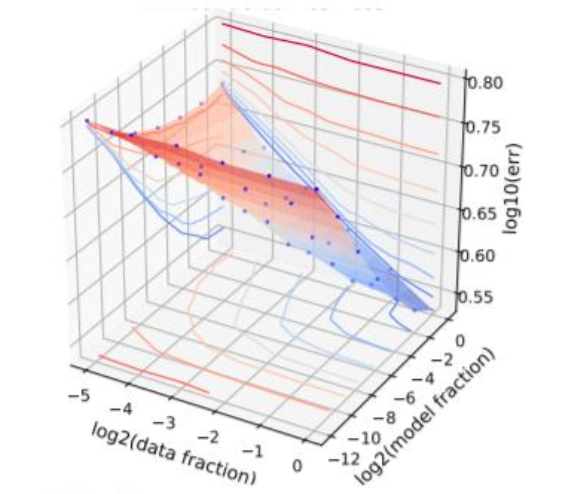
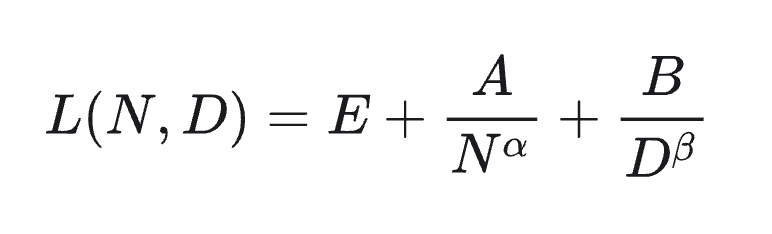
Data & Model Joint Scaling is Accurate
Data & Model Joint Scaling is Accurate
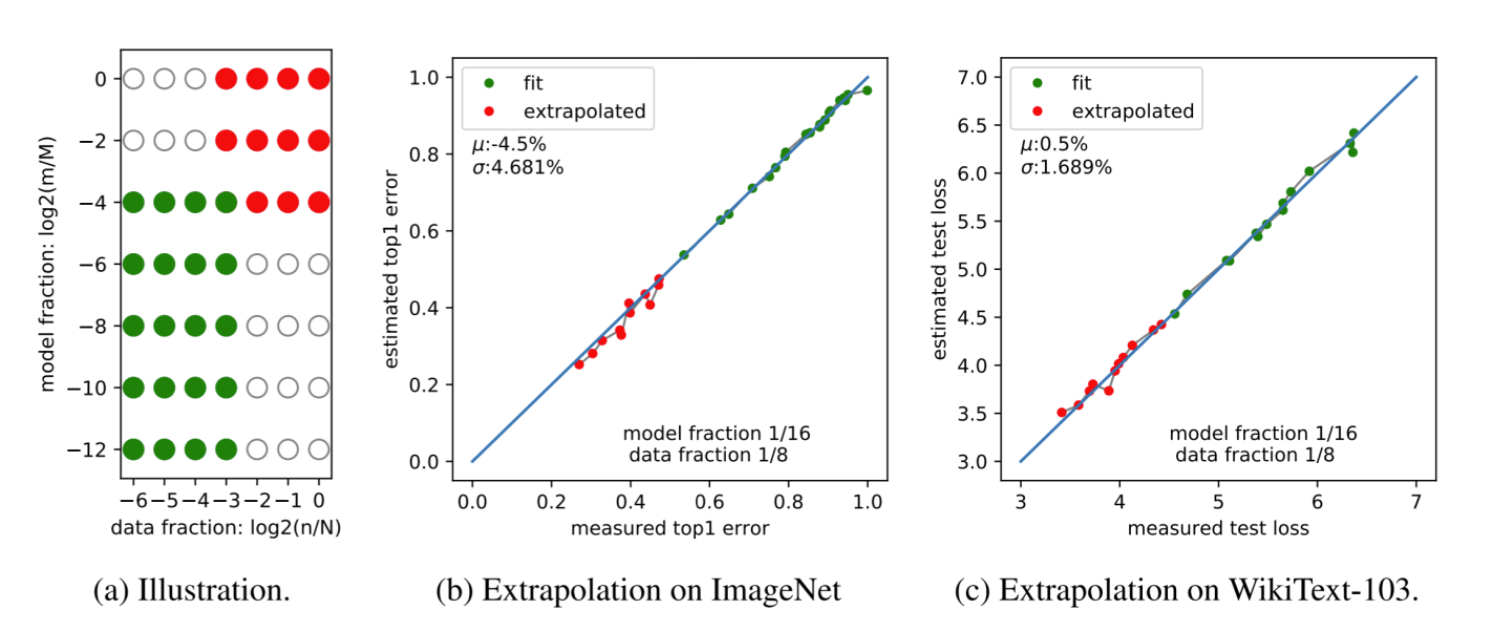
Importance of Scaling Law
Importance of Scaling Law
Predictive Design Principle
Allows researchers to forecast model performance before training. → Helps allocate compute/data/model size optimally.
Drives Paradigm Shift
Shifts focus from architecture engineering to scale-driven performance. → “More data + bigger models + longer training” became a viable recipe.
Foundation for Efficient Training
Informs compute-optimal model design (e.g., Chinchilla Law): → For a fixed compute budget, what’s the best model/data ratio?
Unifies Empirical Trends Across Models
Observed in transformers, language models, vision models, multimodal models… → Suggests a universal scaling behavior in deep learning.
When the Ability Occur? By Emergence
When the Ability Occur? By Emergence
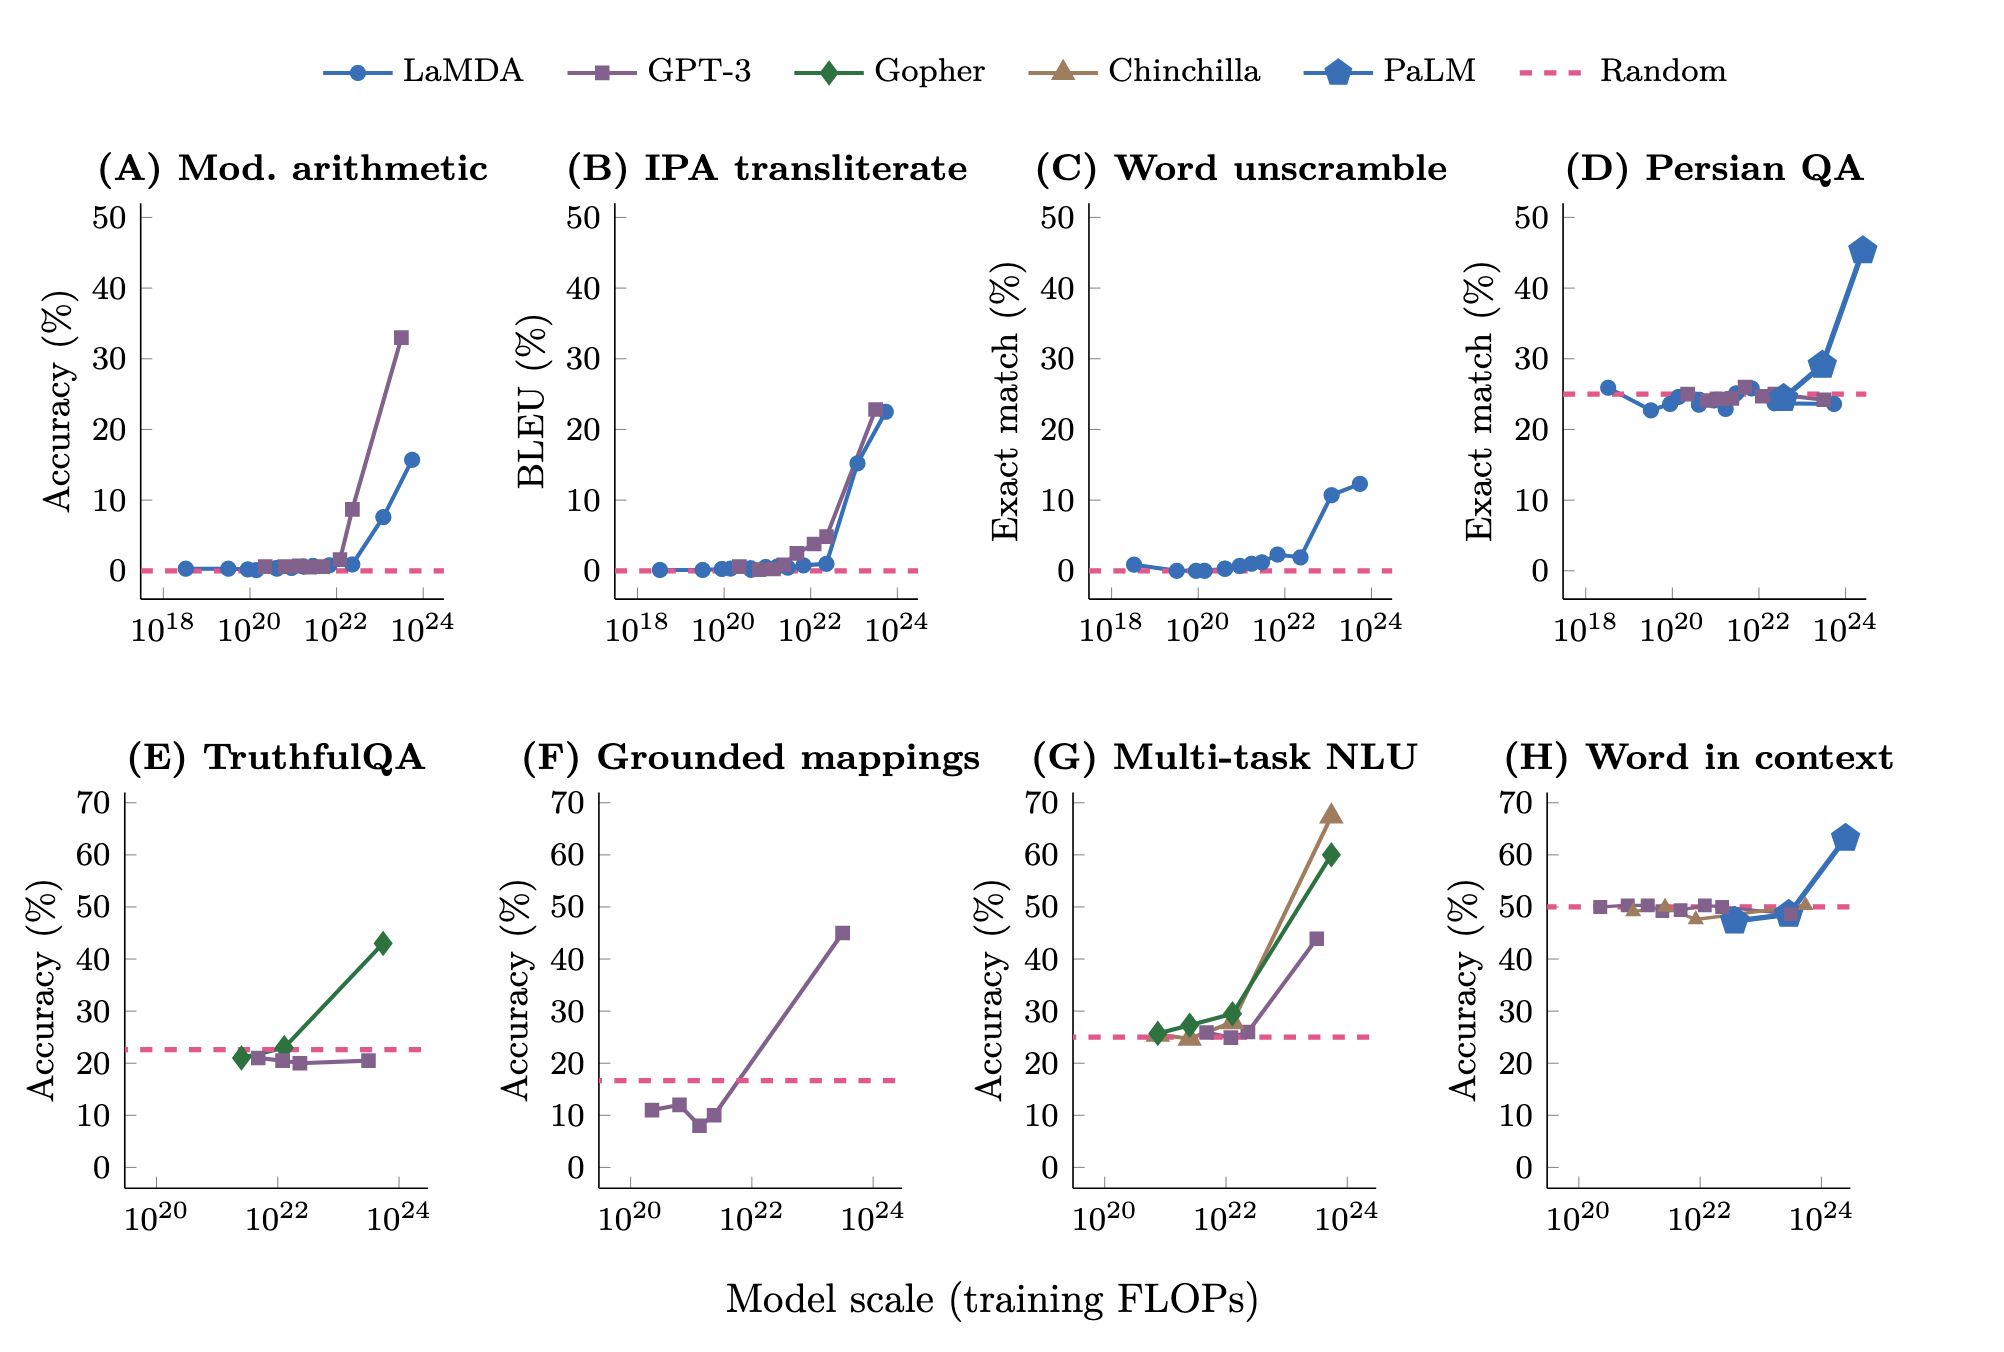
J. Wei, Emergent Abilities of Large Language Models, 2022
Emergence
Emergence
Emergent abilities are capabilities that appear suddenly at a specific scale of model size, data, or compute — not present in smaller models and not predictable by extrapolation.
Key Observations by Wei et al., 2022
Signature Trait: Abrupt, non-linear improvements in task performance as model size increases
Suggests a qualitative shift in general-purpose intelligence with sufficient scale.
Emergence: Critiques
Emergence: Critiques
“Are Emergent Abilities a Mirage?” (Schaeffer et al., 2023)
Apparent emergence may result from misleading evaluation scales (e.g., log accuracy)
When plotted properly, performance follows smooth scaling for most tasks
“What Makes In-Context Learning Work?” (Min et al., 2022)
Prompt formatting and input distribution strongly affect observed abilities
Abilities are sensitive, not necessarily emergent
Other Key Critiques:
Some tasks never exhibit emergence
Emergence may reflect training data overlap, not true generalization
Different abilities emerge at different scales — no unified threshold
Emergence
Emergence
Emergence is not entirely an illusion, but it requires more precise definitions and measurement methodologies.
It is more likely a complex phenomenon that arises from the interaction among task type, model scale, prompt design, and data distribution, rather than being controlled by a single factor.
Emergent abilities remain an important but debated phenomenon. To harness them, we need better diagnostics, metrics, and theory.
Why the Ability of LLM?
Why the Ability of LLM?
From the Language Model: The model learns to predict the next word given a sequence of previous words.
During training, the model is exposed to a vast variety of textual patterns, including:
Instructions + answers
Lists, tables, dialogue turns
Textbook examples, Q&A pairs, code examples, etc.
🧠 Key Insight: In-context learning is not explicitly trained, but rather emerges because the model memorizes and generalizes over millions of task-format patterns in natural data.
Why the Ability of LLM?
Why the Ability of LLM?
Large LMs perform implicit meta-learning:
🔬 Idea:
During pretraining, the model sees many sequences of the form:
"Input A → Output A, Input B → Output B, Input C → ?"
The model learns a general mechanism:
“Given a few demonstrations, infer the mapping rule and apply it to the new input.”
This is analogous to meta-learning (“learning to learn”) in traditional ML:
Instead of explicitly optimizing for task adaptation , GPT-3 internalizes the meta-structure of many tasks through exposure to patterns.
2.5 Large Language Models 2.5.2 Supervised Instruction Fine-Tuning
2.5 Large Language Models 2.5.2 Supervised Instruction Fine-Tuning
Why Supervised Instruction Fine-Tuning (SFT)
Why Supervised Instruction Fine-Tuning (SFT)
Why do we need instruction fine-tuning?
LLMs are pretrained on diverse web-scale corpora: code, books, Wikipedia, etc.
Pretrained LLMs are Good at Text continuation task, including few shot in-context learning;
But no notion of task-specific instruction.
Example: “Summarize the following paragraph…” → Base LLM often fails.
Goal: Align model behavior with human-intended instructions.
Instruction Fine-Tuning
Instruction Fine-Tuning
Definition: Supervised fine-tuning of a pretrained LLM on (instruction, response) pairs.
Also known as supervised fine-tuning (SFT) stage in alignment pipeline.
Shift from pretraining objective to task-oriented alignment.
Learn to map:
Ex: Instruction: “Translate to French”, Input: “Hello” → Output: “Bonjour”
Type of Instruction Data
Type of Instruction Data
Natural language instructions + labeled outputs.
Sources:
NLP benchmarks (SuperGLUE, SQuAD, etc.)
Crowd-sourced instruction sets (e.g., Self-Instruct)
Synthetic instructions from models themselves.
Recall: Multi-Task in T5
Recall: Multi-Task in T5
T5 converts every task into a text-in → text-out format. For example:
Sentiment classification:
Input: "sst2 sentence: I liked the movie.”
Output: "positive”
Summarization:
Input: "summarize: [article text]”
Output: "[short summary]”
Translation:
Input: "translate English to German: How are you?”
Output: "Wie geht es dir?”
Fixed Labels, not flexible nature instructions.
Algorithm: Supervised Finetuning
Algorithm: Supervised Finetuning
Objective:
where
Can be applied in various pretrained models: T5, GPT 3 …
Historical Mile-Stones
Historical Mile-Stones
FLAN (2021): Unified instruction tuning on 60+ tasks.
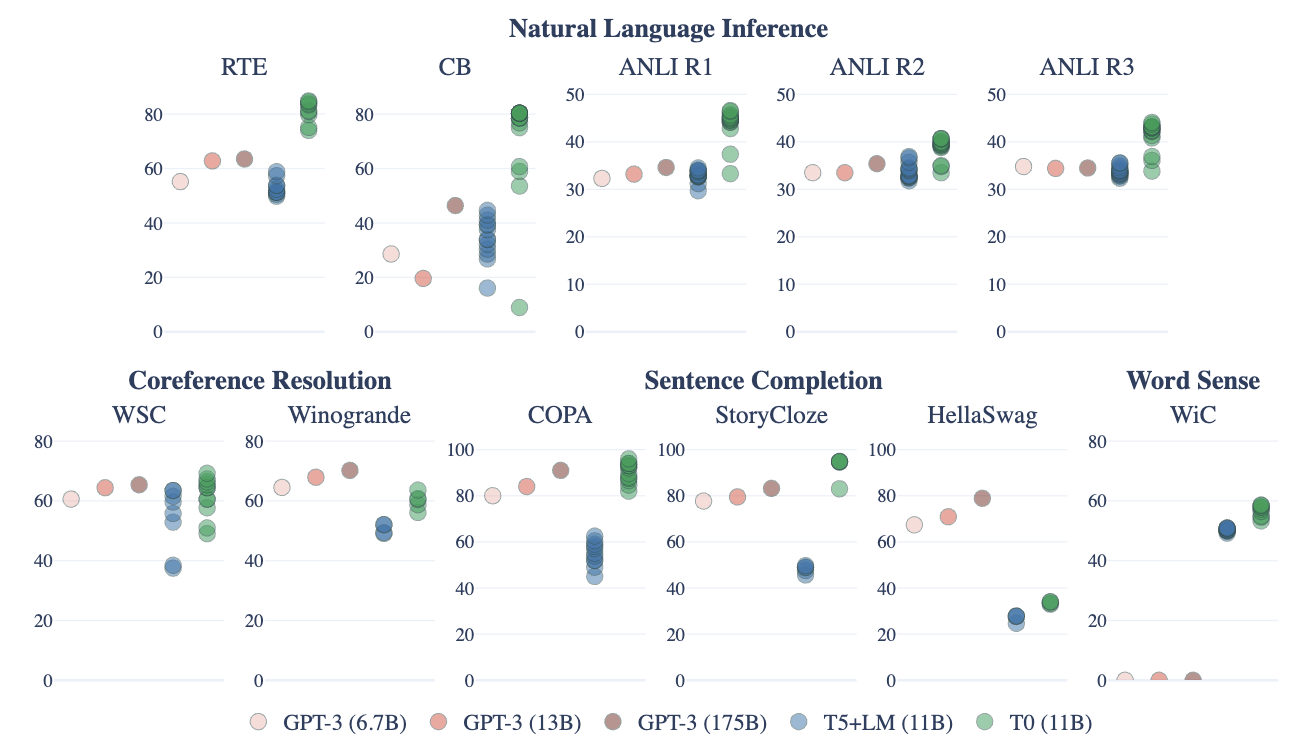
T0 (2021): Zero-shot generalization via multitask instruction tuning.
InstructGPT (2022): Supervised + RLHF training for instruction following.
FLAN
FLAN
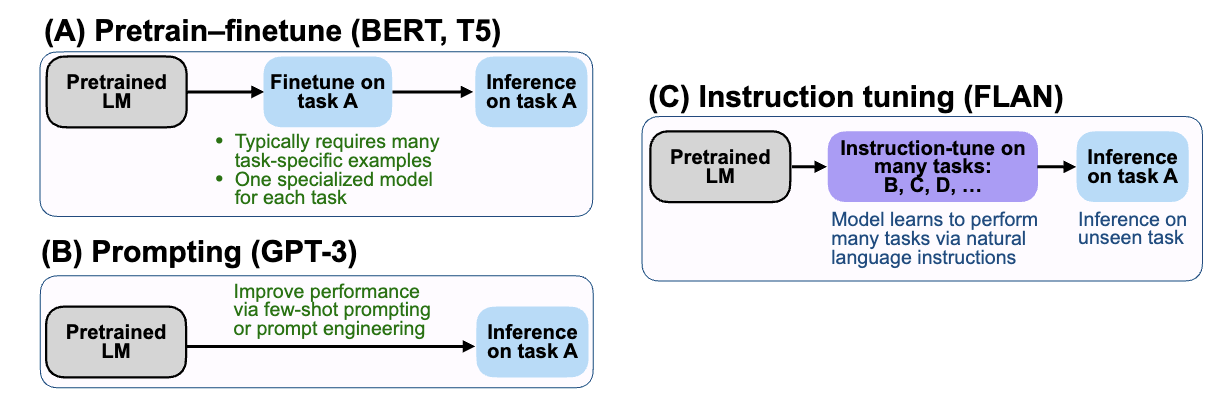
J. Wei, Finetuned Language Models Are Zero-Shot Learners, 2022
FLAN
FLAN
J. Wei, Finetuned Language Models Are Zero-Shot Learners, 2022
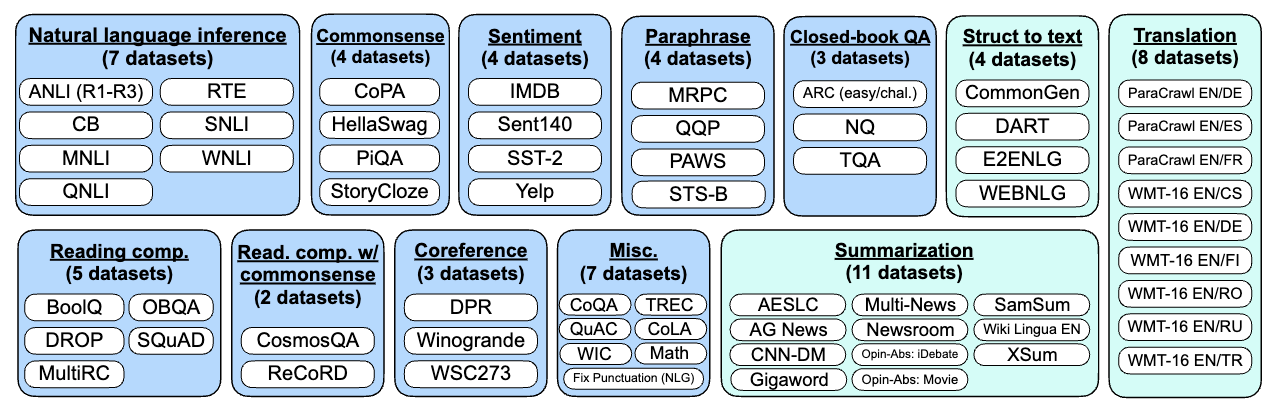
FLAN
FLAN
J. Wei, Finetuned Language Models Are Zero-Shot Learners, 2022
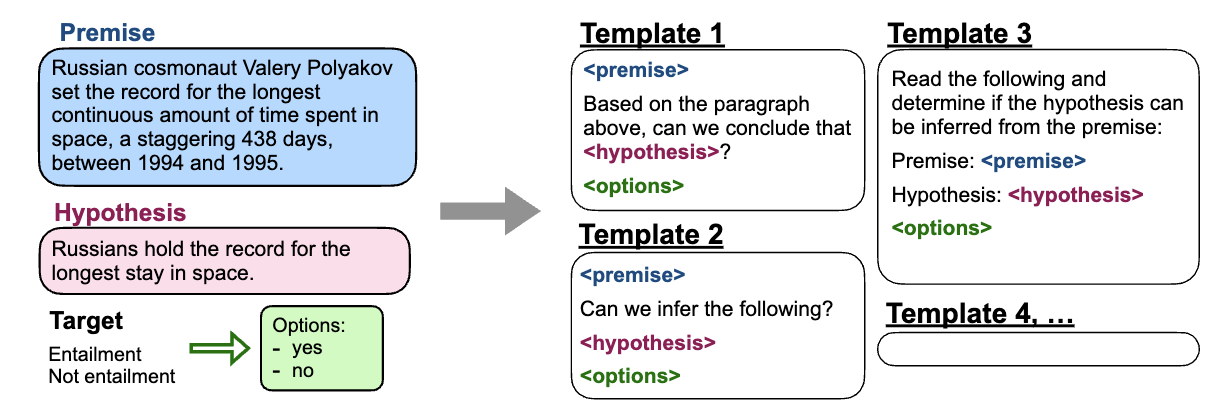
T0
T0
V. Sanh, et.al, Multitask Prompted Training Enables Zero-Shot Task Generalization, 2022
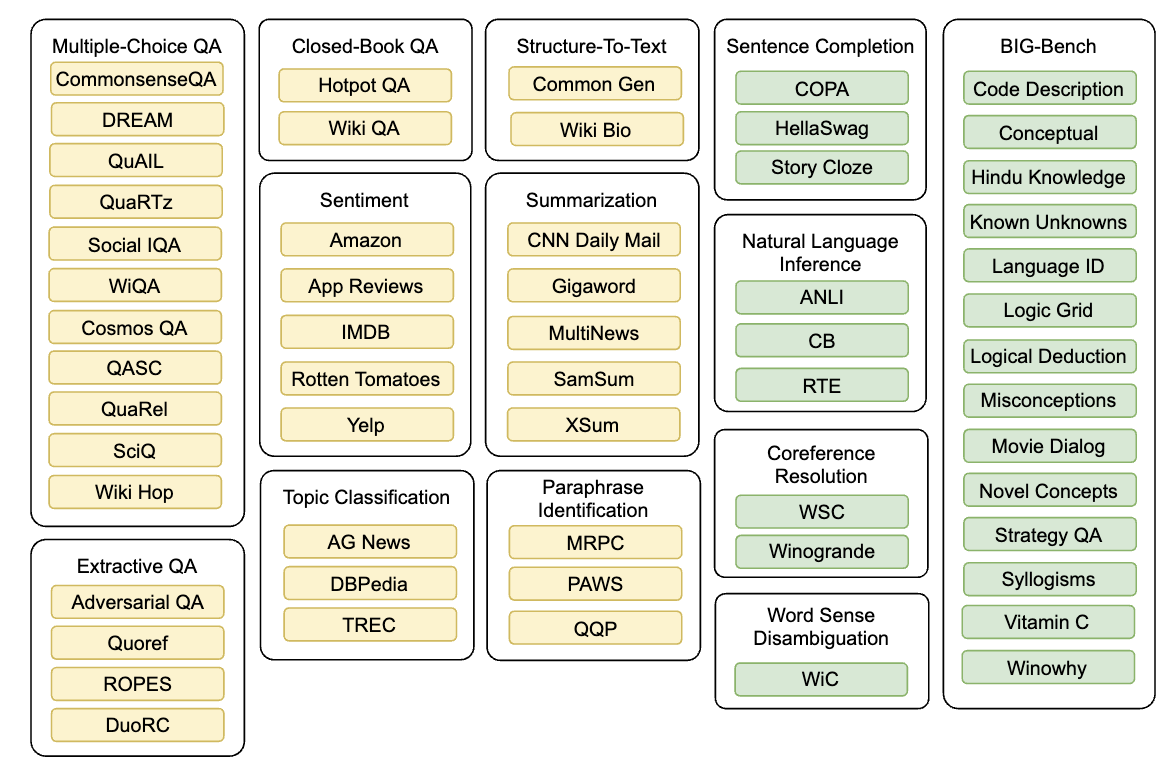
T0
T0
V. Sanh, et.al, Multitask Prompted Training Enables Zero-Shot Task Generalization, 2022
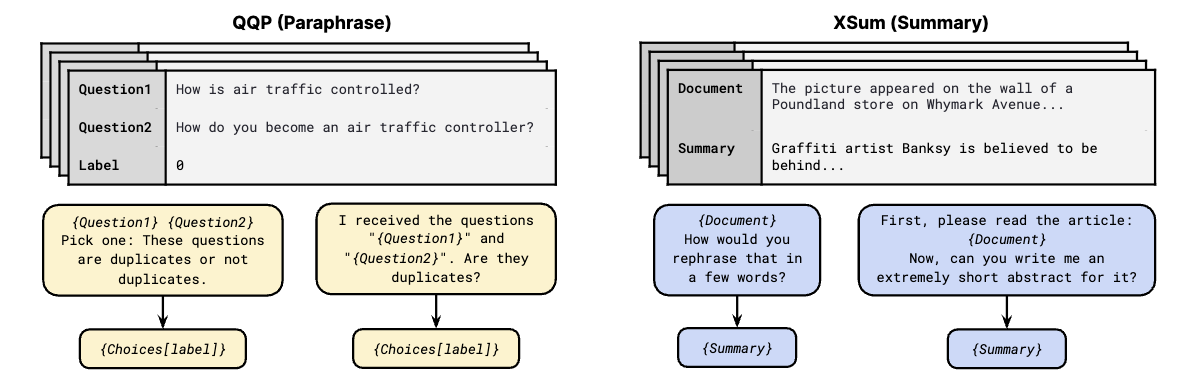
T0
T0
V. Sanh, et.al, Multitask Prompted Training Enables Zero-Shot Task Generalization, 2022
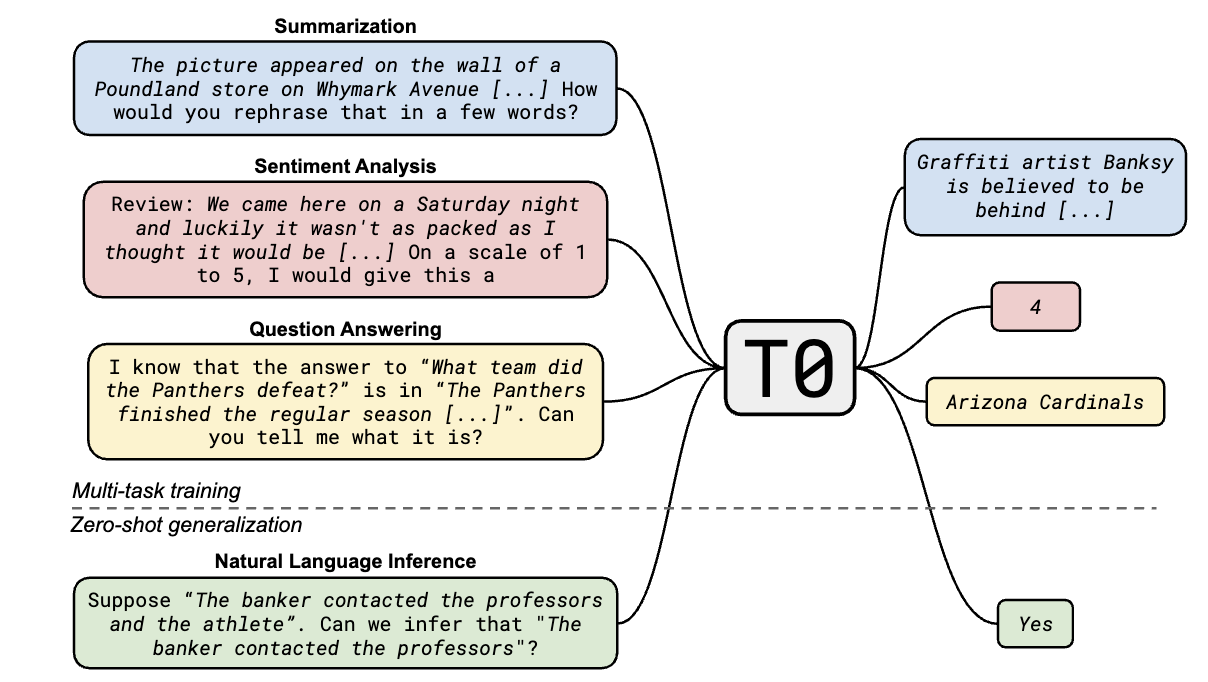
T0
T0
V. Sanh, et.al, Multitask Prompted Training Enables Zero-Shot Task Generalization, 2022
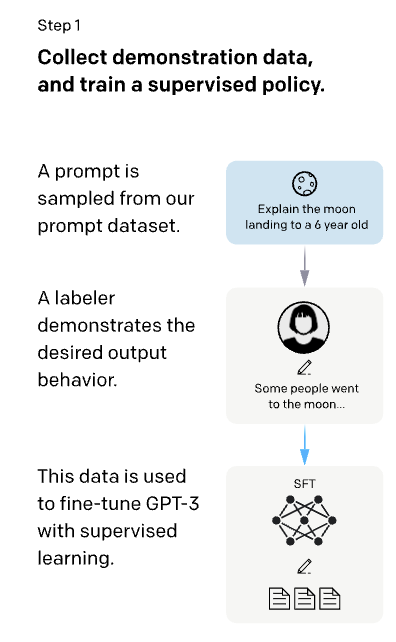
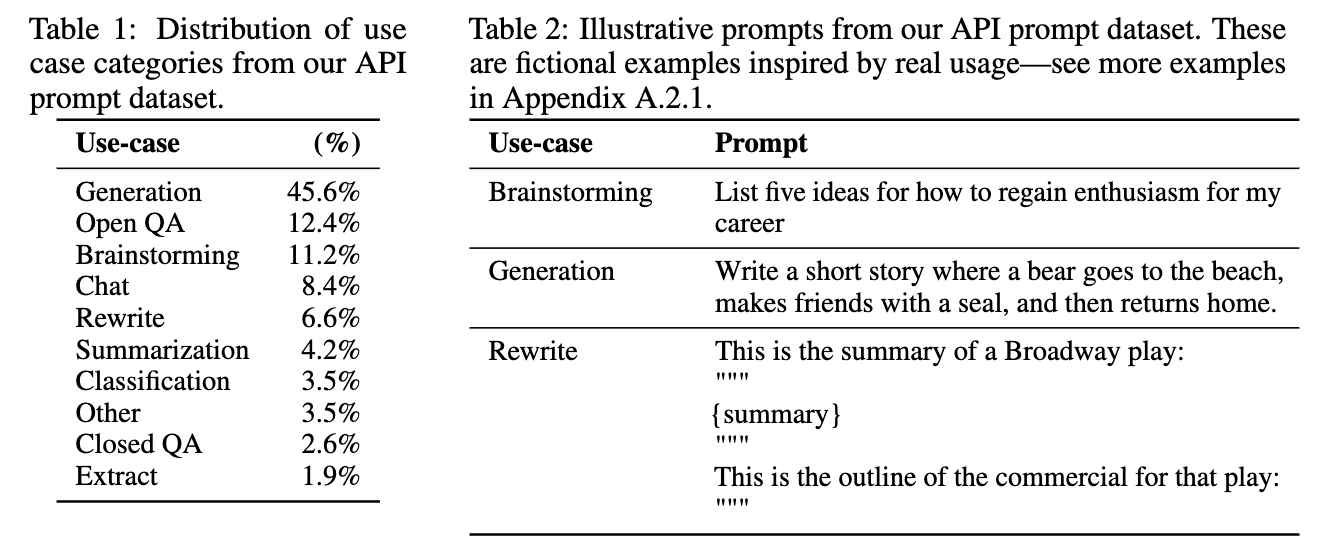
Instruct-GPT
Instruct-GPT
L. Ouyang, Training language models to follow instructions with human feedback, 2022.
Summary
Summary
All methods create natural language instructed supervised data:
From existing NLP tasks;
Human Label (Open AI)
A pretrained LLM are fine-tuned in this dataset;
The zero-shot performances over supervised tasks are improved;
But more importantly, the finetuned models all show promising generalization to instructions outside of the finetuning distribution.
They learn the meaning of natural language instructions.
Gap to Our Goal – Human Intelligence
Gap to Our Goal -- Human Intelligence
SFT cannot fully achieve our goal -- Human Preference
Learns to Mimic, Not to Optimize Preferences
Cannot Resolve Ambiguities or Trade-offs
Passive and Non-Interactive
Overfits to Demonstration Distribution
Cannot Penalize Undesirable Outputs
2.5 Large Language Models 2.5.3 Reinforcement Learning from Human Feedback
2.5 Large Language Models 2.5.3 Reinforcement Learning from Human Feedback
How to achieve Human Preference?
How to achieve Human Preference?
First, we need to model human preference, that is, tell how well the result satisfies humans requests.
Human preference is expensive and slow!
Human preference hard to model by rules on language responses;
How about build a machine learning model?
Given each response, the human preference model will give a score indicating the quality of the response;
Second, we need to optimize our LLM to generate responses with high scores given by the human preference model:
Reinforcement Learning is the best choice.
Architecture of ChatGPT
Architecture of ChatGPT
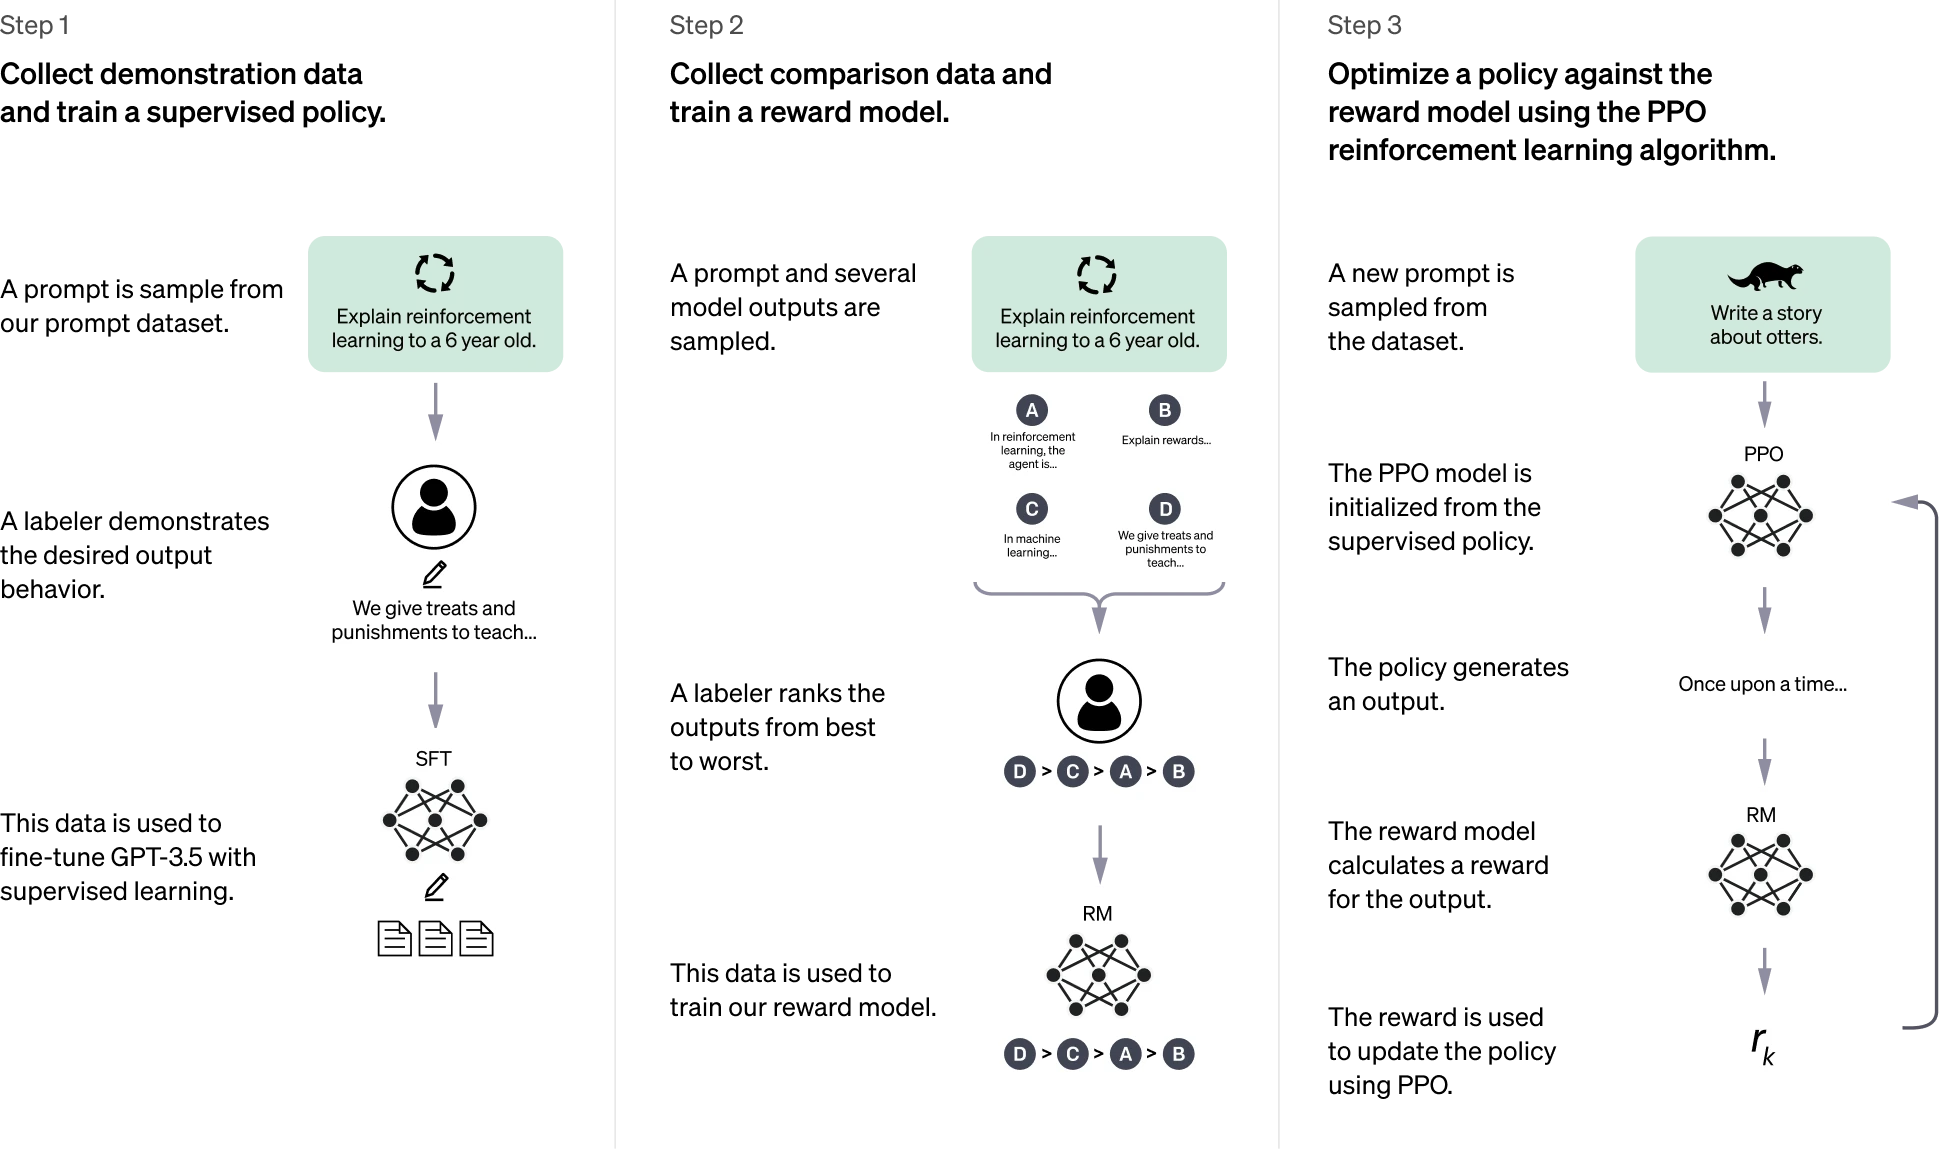
https://openai.com/index/chatgpt/
Instruction Finetuning
RLHF
History of RLHFEarly Developments in Human-in-the-Loop Reinforcement Learning
History of RLHF
Early Developments in Human-in-the-Loop Reinforcement Learning
Early Developments in Human-in-the-Loop Reinforcement Learning
Early approaches had humans directly guiding agent behavior via rewards or corrections.
TAMER (2008) allowed humans to provide scalar feedback signals (positive/negative) in real time to train an agent. This taught agents by shaping a reward model from human evaluations, rather than a predefined reward.
COACH (2017) introduced an actor-critic method where human feedback adjusted the critic’s advantage estimates. These early works established that humans can meaningfully shape an agent’s policy during learning.
Preference-based Reinforcement Learning (PbRL, 2011) : humans express preferences between two outcomes, and the agent learns a policy that produces outcomes ranking higher in human preference. This set the stage for modern RLHF – learning from comparative feedback rather than absolute reward signals.
History of RLHFEmergence of RLHF in the Deep Learning Era (2016–2018)
History of RLHF
Emergence of RLHF in the Deep Learning Era (2016–2018)
Emergence of RLHF in the Deep Learning Era (2016–2018)
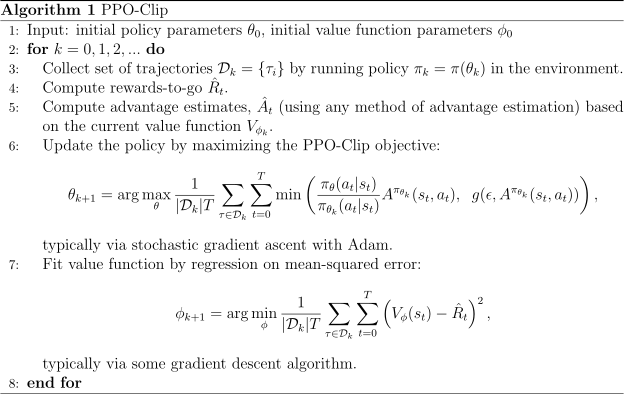
The Proximal Policy Optimization (PPO, 2017) algorithm provided a stable and efficient way to fine-tune policies in large parameter spaces.
The modern wave of RLHF research took off with the success of deep reinforcement learning. By the late 2010s, RLHF techniques were being tested in complex domains, especially in games.
In Christiano et al. (OpenAI, 2017) humans compared pairs of short video clips of an agent’s behavior , and a neural reward model was trained from these comparisons.
OpenAI Five (which played Dota 2) and DeepMind’s AlphaStar (which played StarCraft II) incorporated human demonstrations or preference-based fine-tuning.
History of RLHFRLHF for Language Models (2019–2021)
History of RLHF
RLHF for Language Models (2019–2021)
RLHF for Language Models (2019–2021)
Early large language models could produce fluent text but often in ways misaligned with user intent (e.g. going off-topic or being inappropriate).
Ziegler et al. (2019) and Stiennon et al. (2020) fine-tuned GPT-2 on tasks like summarization and dialogue using human preference comparisons.
OpenAI’s WebGPT (2021) trained a model to answer questions using a web browser, with human evaluators rewarding answers that were correct and had proper citations.
DeepMind’s GopherCite (2022) similarly used human feedback to encourage a language model to provide sources for its claims.
RLHF provides gains over pretraining + finetuning
RLHF provides gains over pretraining + finetuning
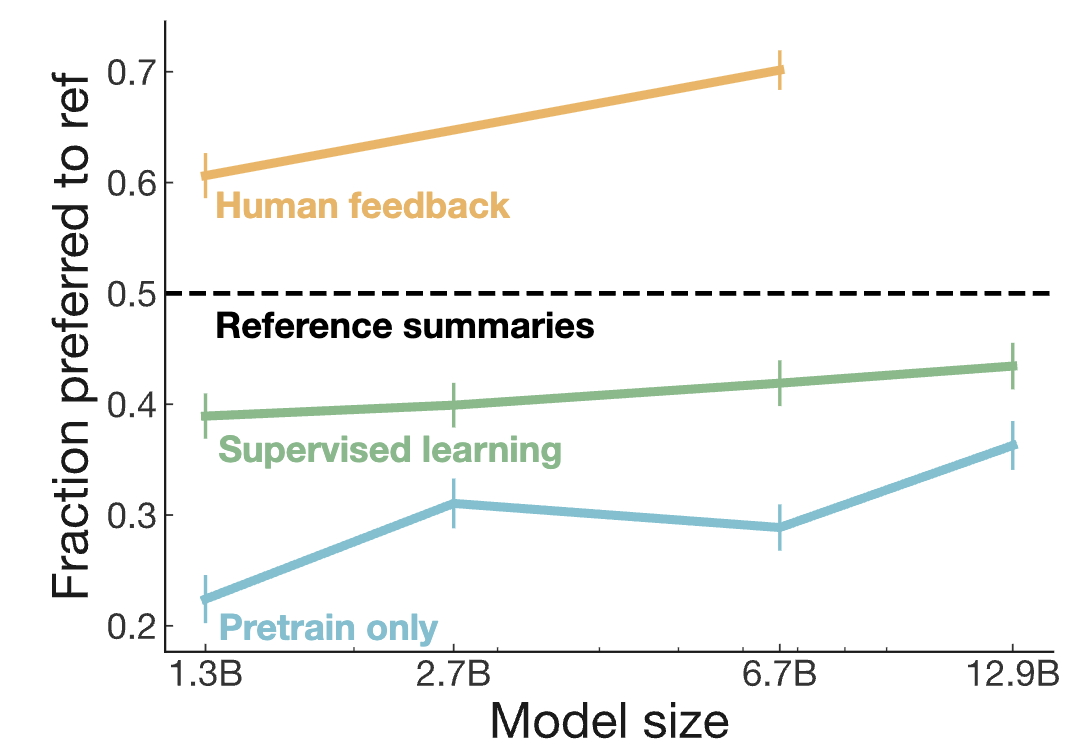
https://arxiv.org/pdf/2009.01325
History of RLHFInstruction-Following and the ChatGPT Era
History of RLHF
Instruction-Following and the ChatGPT Era
Instruction-Following and the ChatGPT Era
OpenAI’s InstructGPT (Ouyang et al., 2022) demonstrated that RLHF can make models dramatically more useful.
InstructGPT also exhibited improvements in truthfulness and reductions in toxic or harmful content compared to the base model – a significant proof that RLHF can enhance both helpfulness and safety of AI systems.
OpenAI’s ChatGPT (2022) is fine-tuned with human feedback for conversational dialogue.
By 2023, RLHF became a standard component for state-of-the-art language models across the AI industry: OpenAI’s GPT-4 (2023) , Anthropic’s Claude, LLaMA-2 (Meta, 2023) , Google’s dialogue models (e.g. LaMDA, Bard).
Incorporating Human Preference
Incorporating Human Preference
Human Preference is expensive and slow!
Train an LM 𝑅𝑀𝜙 𝑠 to predict human preferences from an annotated dataset, then optimize for 𝑅𝑀𝜙 instead.
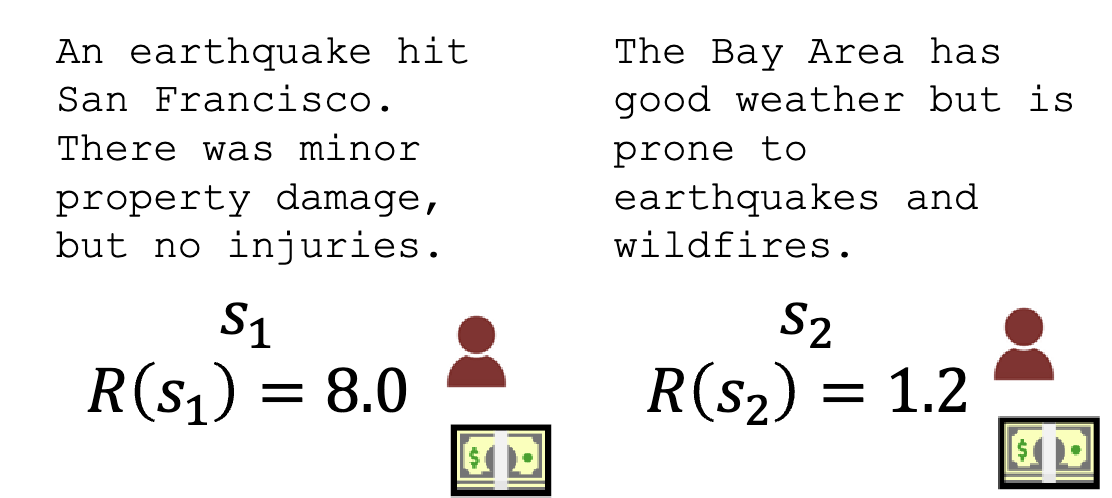
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture10-instruction-tunining-rlhf.pdf
Incorporating Human Preference
Incorporating Human Preference
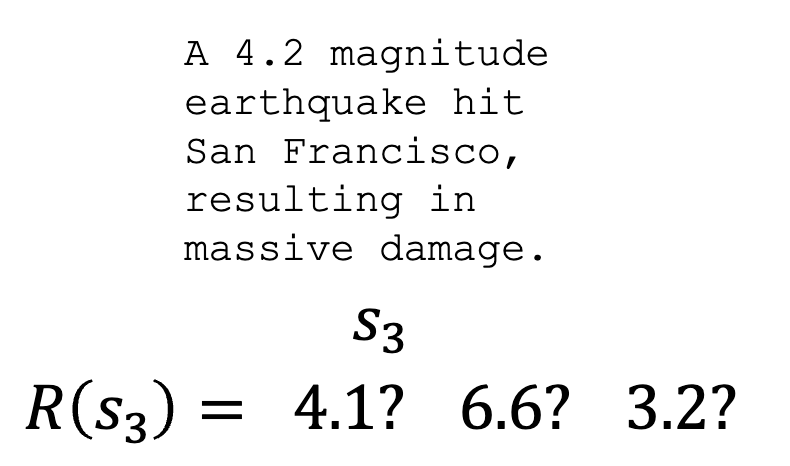
Human judgments are noisy and miscalibrated!
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture10-instruction-tunining-rlhf.pdf
Incorporating Human Preference
Incorporating Human Preference
Solution: instead of asking for direct ratings, ask for pairwise comparisons, which can be more reliable
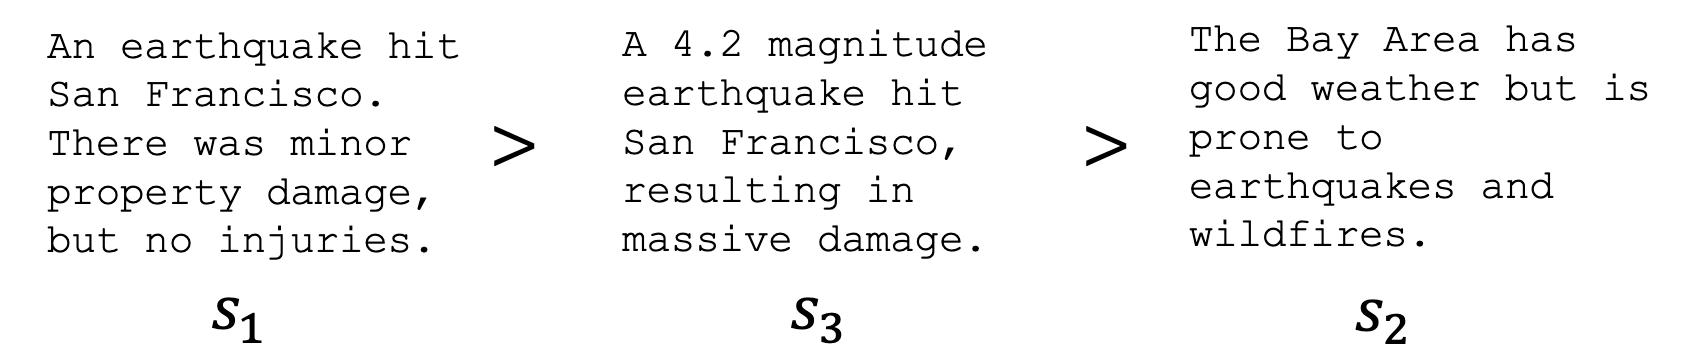
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture10-instruction-tunining-rlhf.pdf
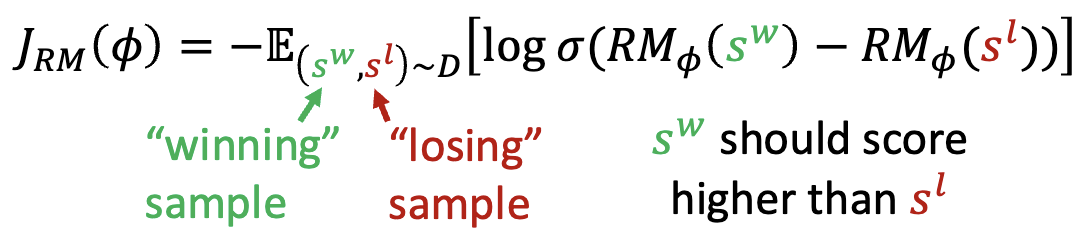
Reward Model In RLHF
Reward Model In RLHF
Start from the SFT model (e.g., GPT-style autoregressive model).
Add a scalar head on top of the final hidden state of the output sequence
Train a rank model
https://web.stanford.edu/class/cs224n/slides_w25/cs224n-2025-lecture10-instruction-tunining-rlhf.pdf
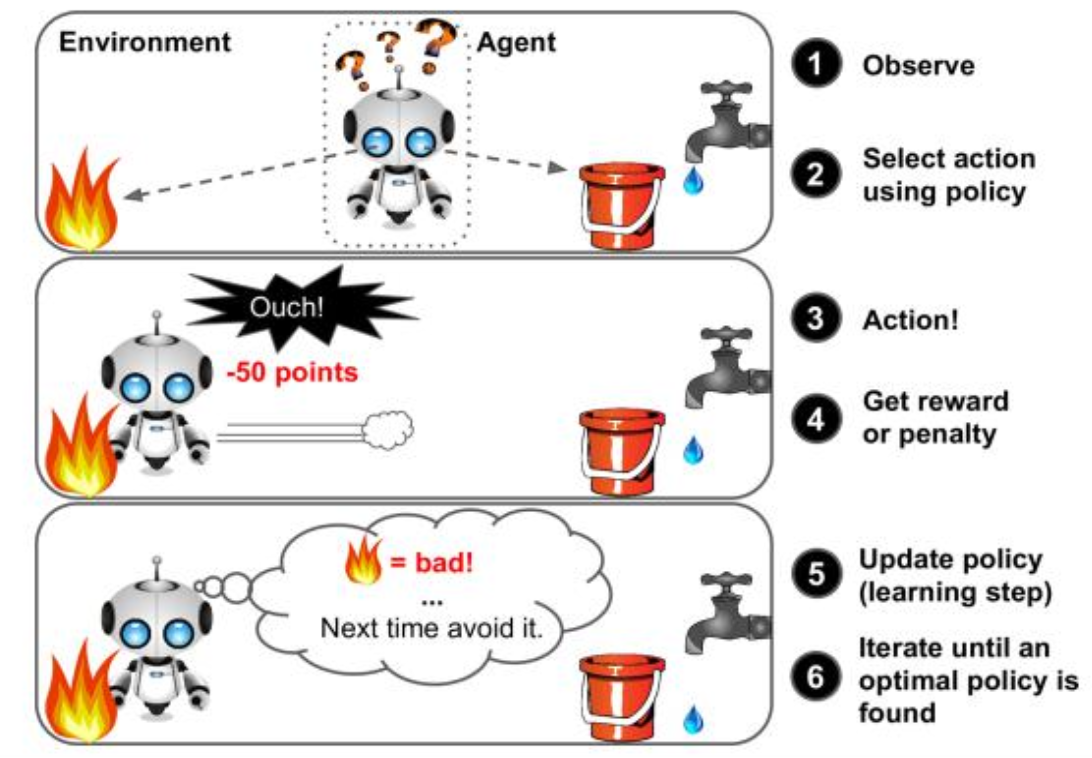
Recall: Reinforcement Learning
Recall: Reinforcement Learning
Agent learns to make decisions by interacting with an environment to maximize a reward signal over time.
Exploration vs. Exploitation:
Exploration refers to trying new actions to discover potentially better rewards.
Exploitation means choosing the action that gives the highest known reward based on past experience.
The agent interacts with the environment by taking actions, receiving rewards, and updating its policy to maximize future rewards.
Recall: Reinforcement Learning
Recall: Reinforcement Learning
https://www.slideshare.net/slideshow/the-fundamentals-of-machine-learning/238653218
Reinforcement Learning
Reinforcement Learning
https://medium.com/@binaydhakal35/mdp-markov-decision-process-rl-reinforcement-learning-bc85e5d25031
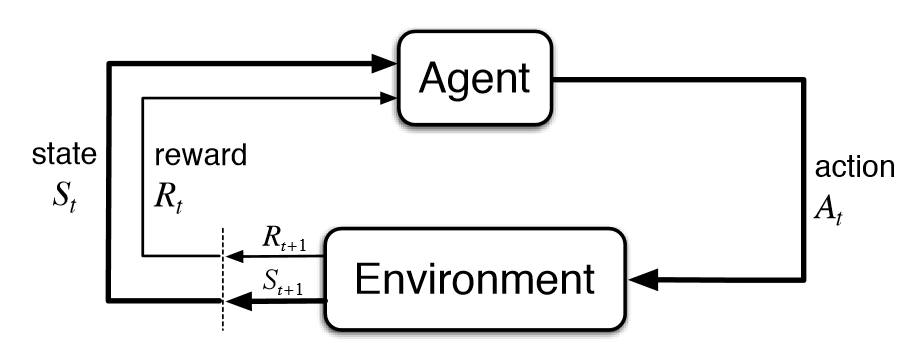
Reinforcement Learning Markov Decision Process
Reinforcement Learning
Markov Decision Process
Markov Decision Process
An MDP is defined by a tuple ,where:
(State Space): A set of states representing the environment.
(Action Space): A set of actions available to the agent in each state.
(Transition Probability): A probability function that defines the likelihood of transitioning from state s to s' after taking action a.
(Reward Function): A function that assigns a reward for moving from state s to s' via action a.
(Discount Factor): A value in the range [0,1] that determines the importance of future rewards.
Reinforcement LearningMarkov Property
Reinforcement Learning
Markov Property
Markov Property
MDP follows the Markov Property, which states that the next state depends only on the current state and action, not on past states.
Mathematically,
This property ensures that MDPs can be efficiently solved using mathematical techniques like dynamic programming.
Reinforcement LearningPolicy and Value
Reinforcement Learning
Policy and Value
Policy and Value
The policy is defined as a probability distribution over actions given a state.
The optimal policy is the one that maximizes the expected cumulative reward, denoted as:
Reinforcement Learning is to find the optimal policy.
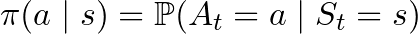
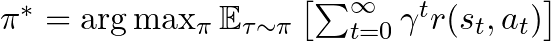
Reinforcement Learning for LLM
Reinforcement Learning for LLM
Train the language model to maximize the reward model score:
This is a deep reinforcement learning setting:
Policy: :a deep autoregressive language model
Reward: scalar from , given at the end of generation
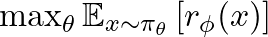
The Policy Gradient Approach
The Policy Gradient Approach
Optimize the objective by gradient ascent:
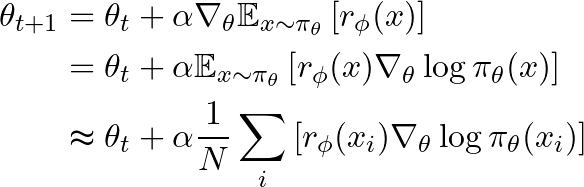
Why not Policy Gradient
Why not Policy Gradient
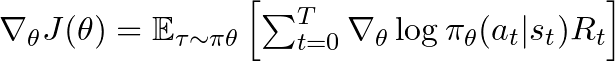
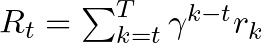
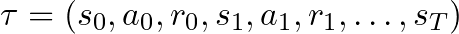
The gradient is modulated by the total return, regardless of how good the action was relative to the state, leading to high variance in gradient estimates.
Actor-Critic
Actor-Critic
Subtracting a state-dependent baseline would greatly reduce the variance
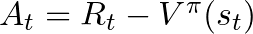
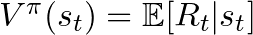
How to choose a good baseline? – Value and Advantage;
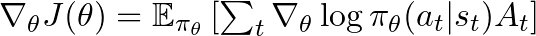
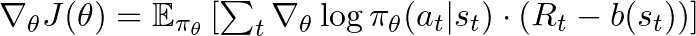
Actor-Critic: Advantage
Actor-Critic: Advantage
Monte Calo (MC) Advantage:
One-Step Time Difference Advantage:
Generalized Advantage Estimation
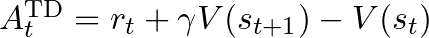
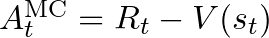
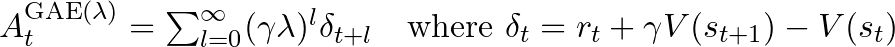
Actor-Critic: Algorithm
Actor-Critic: Algorithm
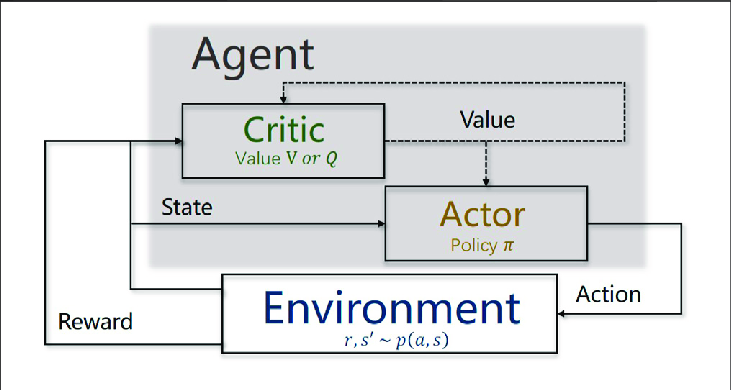
Components:
Actor: the policy , responsible for action selection
Critic: the value function , evaluates how good a state is
Procedure:
Actor chooses actions based on
Critic computes
Collect trajectory
Critic updates by minimizing:
Actor updates using:
The Actor-Critic Approach
The Actor-Critic Approach
https://www.researchgate.net/figure/The-Markov-decision-process-of-reinforcement-learning-According-to-the-reward-the_fig1_368578437
Why not Actor-Critic?
Why not Actor-Critic?
Problem in Actor-Critic:
Policy updates can be too large, causing performance collapse
No explicit constraint on how much the policy changes
Trust Region Policy Optimization (TRPO):
Solves this via a KL-divergence constraint
Effective but complex (second-order method)
PPO: Proposes a simple alternative to TRPO with first-order optimization
The PPO Approach
The PPO Approach
https://spinningup.openai.com/en/latest/algorithms/ppo.html
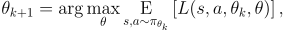
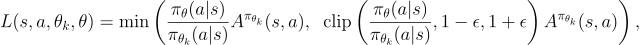
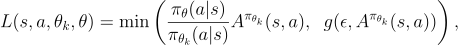
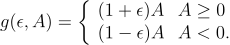
Advantage is positive: the new policy does not benefit by going far away from the old policy. Advantage is negative: the new policy does not benefit by going far away from the old policy.
Advantage is positive: the new policy does not benefit by going far away from the old policy.
Advantage is negative: the new policy does not benefit by going far away from the old policy.
The PPO Approach
https://spinningup.openai.com/en/latest/algorithms/ppo.html
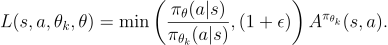
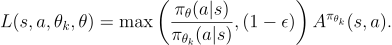
The PPO Approach
The PPO Approach
https://spinningup.openai.com/en/latest/algorithms/ppo.html
PPO In RLHF
PPO In RLHF
Actor: Policy Network
The actor model starts from the SFT model:
Outputs a distribution over tokens:
Critic: Value Network
Also initialized from the SFT model:
A scalar value head is added to the transformer outputs:
PPO In RLHF
PPO In RLHF
Reward: KL divergence is added to the human preference reward as a regularization term, to avoid catastrophic drift from the supervised fine-tuned (SFT) model, which serves as the original “safe” baseline.
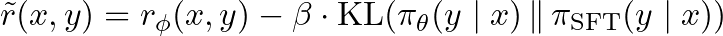
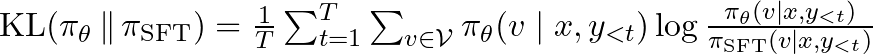
RLHF
RLHF
Finally, we have everything we need:
A pretrained (possibly instruction-finetuned) LM
A reward model that produces scalar rewards for LM outputs, trained on a dataset of human comparisons
A method for optimizing LM parameters towards an arbitrary reward function.
Now to do RLHF:
Initialize the policy network;
Initialize the value network;
Build the regularized reward model;
Optimize the reward with PPO.
Summary
Summary
https://openai.com/index/chatgpt/
2.5 Large Language Models 2.5.4 Decoding Strategies
2.5 Large Language Models 2.5.4 Decoding Strategies
Decoding for Searching the Desired Sequence
Decoding for Searching the Desired Sequence
Search: Find desired Sequences that maximize some objectives, calculated using certain information;
Naïve Solution -- Exhaustive Search:
Search Space: All possible Sequences;
Not feasible with complexity of
Need efficient algorithm!
![XCS224N] Lecture 8 – Translation, Seq2Seq, Attention - mx's blog](assets/ppt-elements/12-image79.png)
Image Source: https://x-wei.github.io/xcs224n-lecture8.html
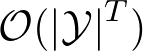
Decoding Problem for Sequence Generation
Decoding Problem for Sequence Generation
Given: A trained LLM;
Problem: Generating a sequence to maximize certain objective using available information;
Objective
What to maximize
Probability, Reward, Variety, …
Information
What can be utilized;
Step probability, value function, knowledge, …
Algorithm
Computationally feasible/efficient;
Capabilities;
I. For Probability Maximization
I. For Probability Maximization
Considering generating a sequence of items from a vocabulary given a condition ;
Information:
Objective: Maximize
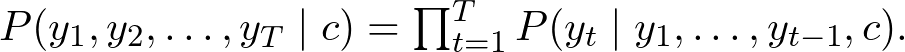
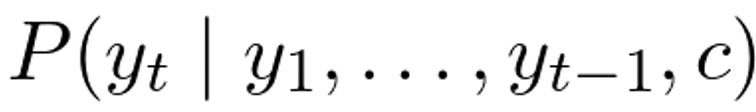
Greedy Search
Greedy Search
At each step, select the token with the highest conditional probability;
Efficient but sub-optimal;
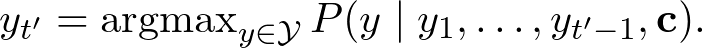
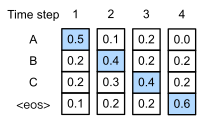
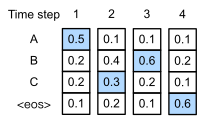
Image Source: https://d2l.ai/chapter_recurrent-modern/beam-search.html
Beam Search
Beam Search
Keep (beam size) sequence in memory;
At each step, consider candidates, and select the top sequence with conditional sequence probability;
Time complexity: ;
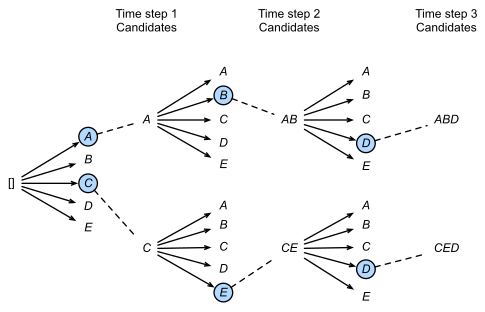
Image Source: https://d2l.ai/chapter_recurrent-modern/beam-search.html
II. For Natural Language
II. For Natural Language
Image Source: Ari Holtzman, et.al, The Curious Case of Neural Text DeGeneration, ICLR, 2020
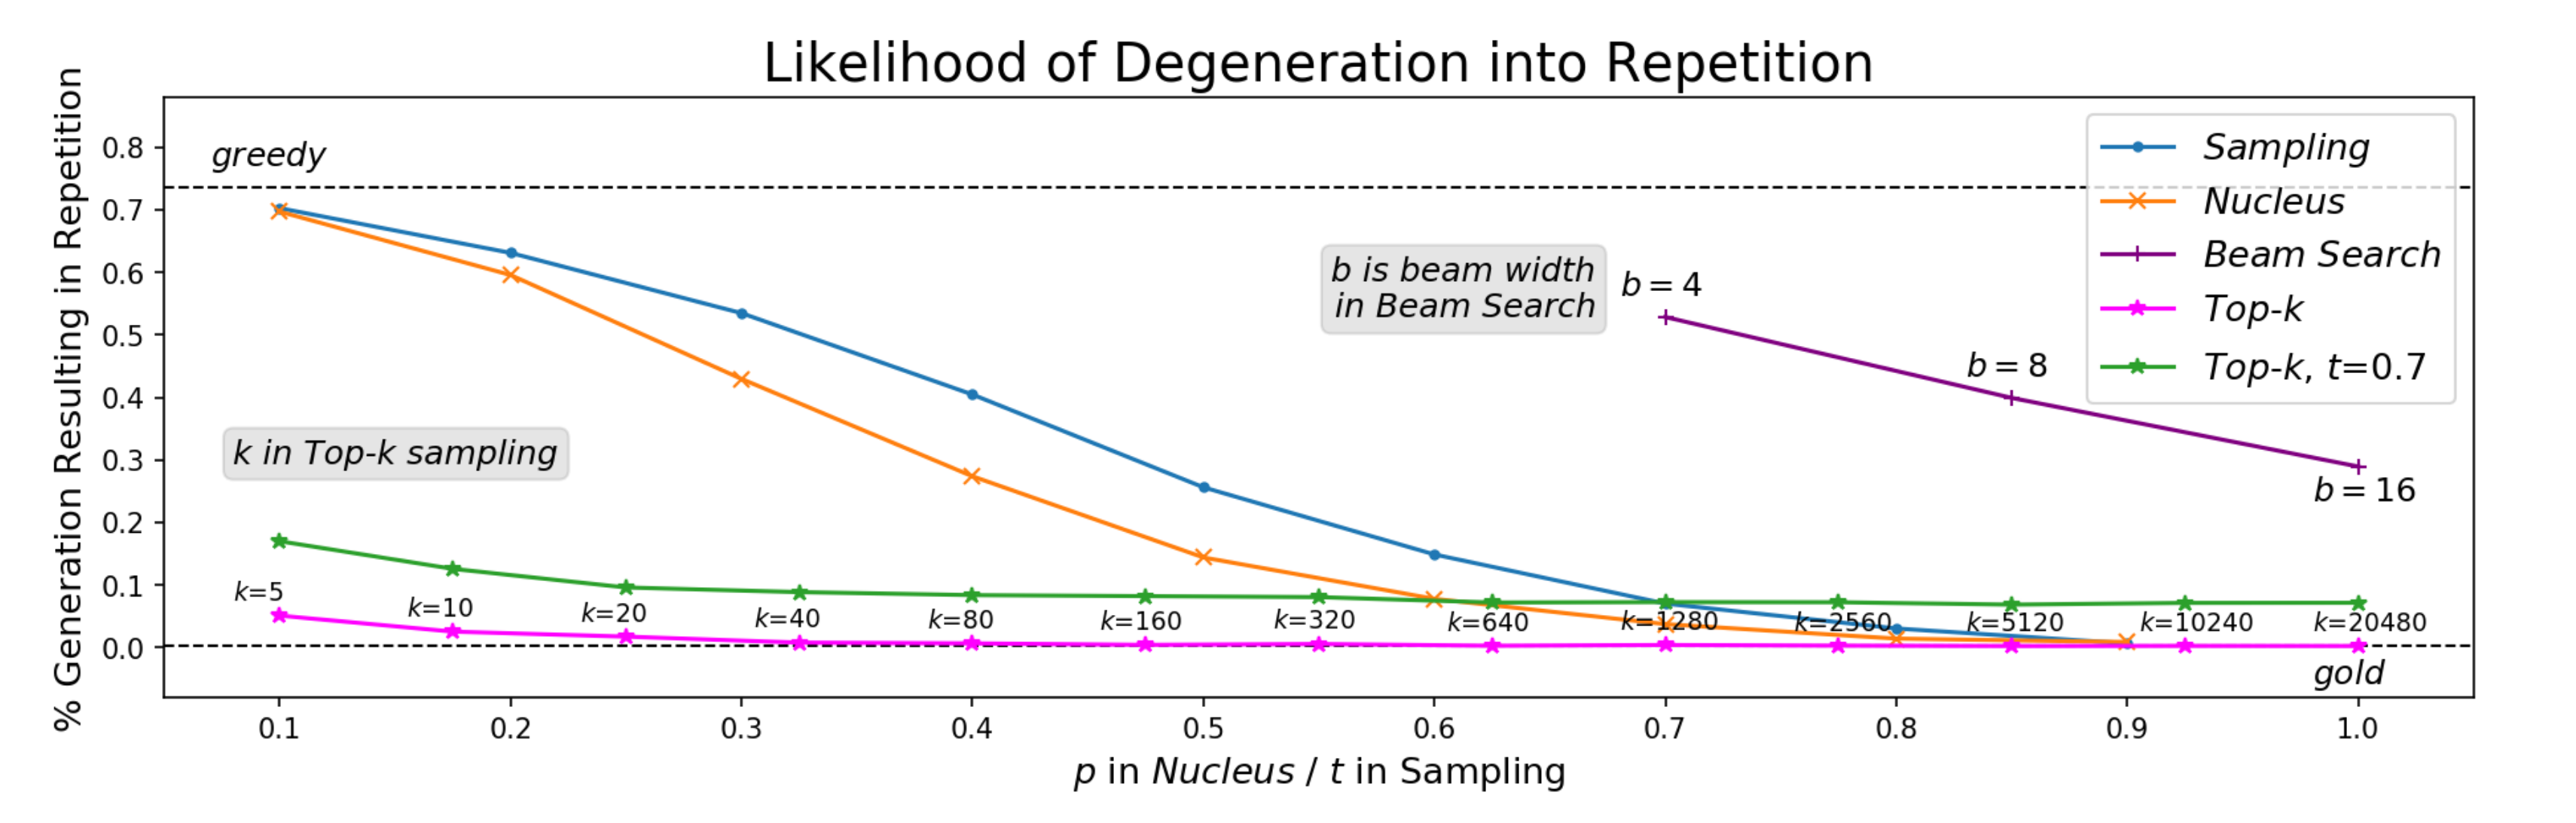
The failure of previous methods in generating open-ended texts
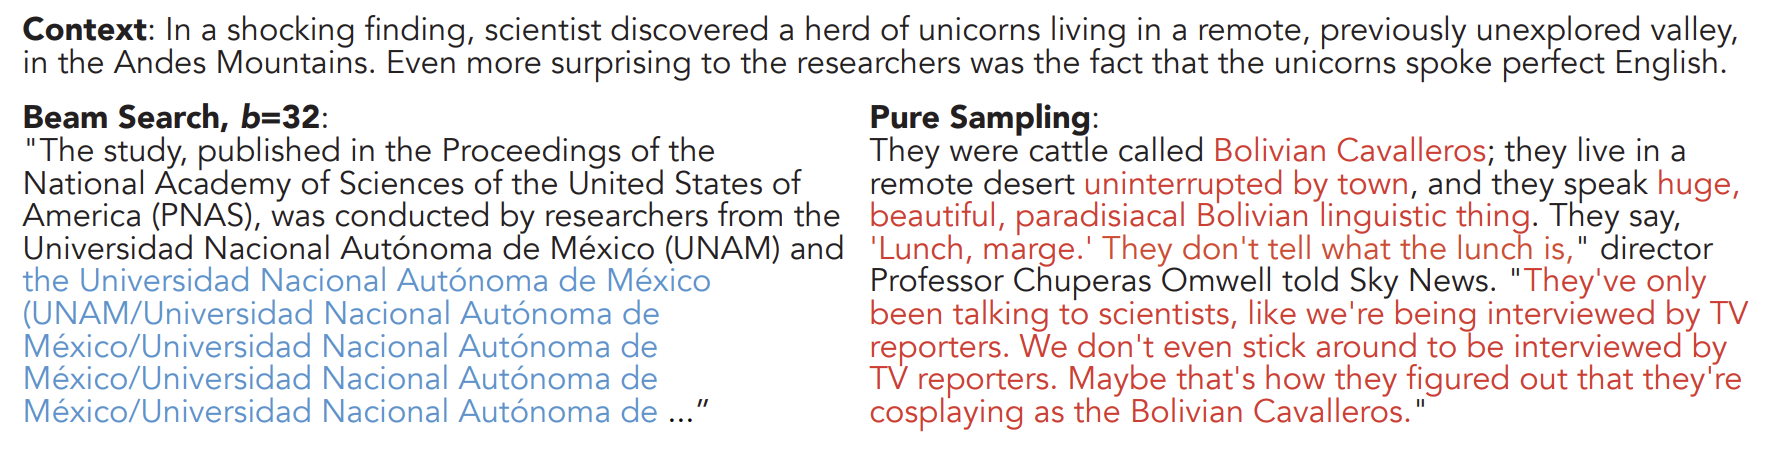
Caused by Objective or Local Minima?
Caused by Objective or Local Minima?
“Natural Language does not maximize probability”[1]
“the per-token probability of natural text is, on average, much lower than text generated by beam search”
Natural languages favor lower-probability but more informative and non-repetitive tokens.
“Grice’s Maxims of Communication (Grice, 1975) show that people optimize against stating the obvious. Thus, making every word as predictable as possible will be disfavored.”
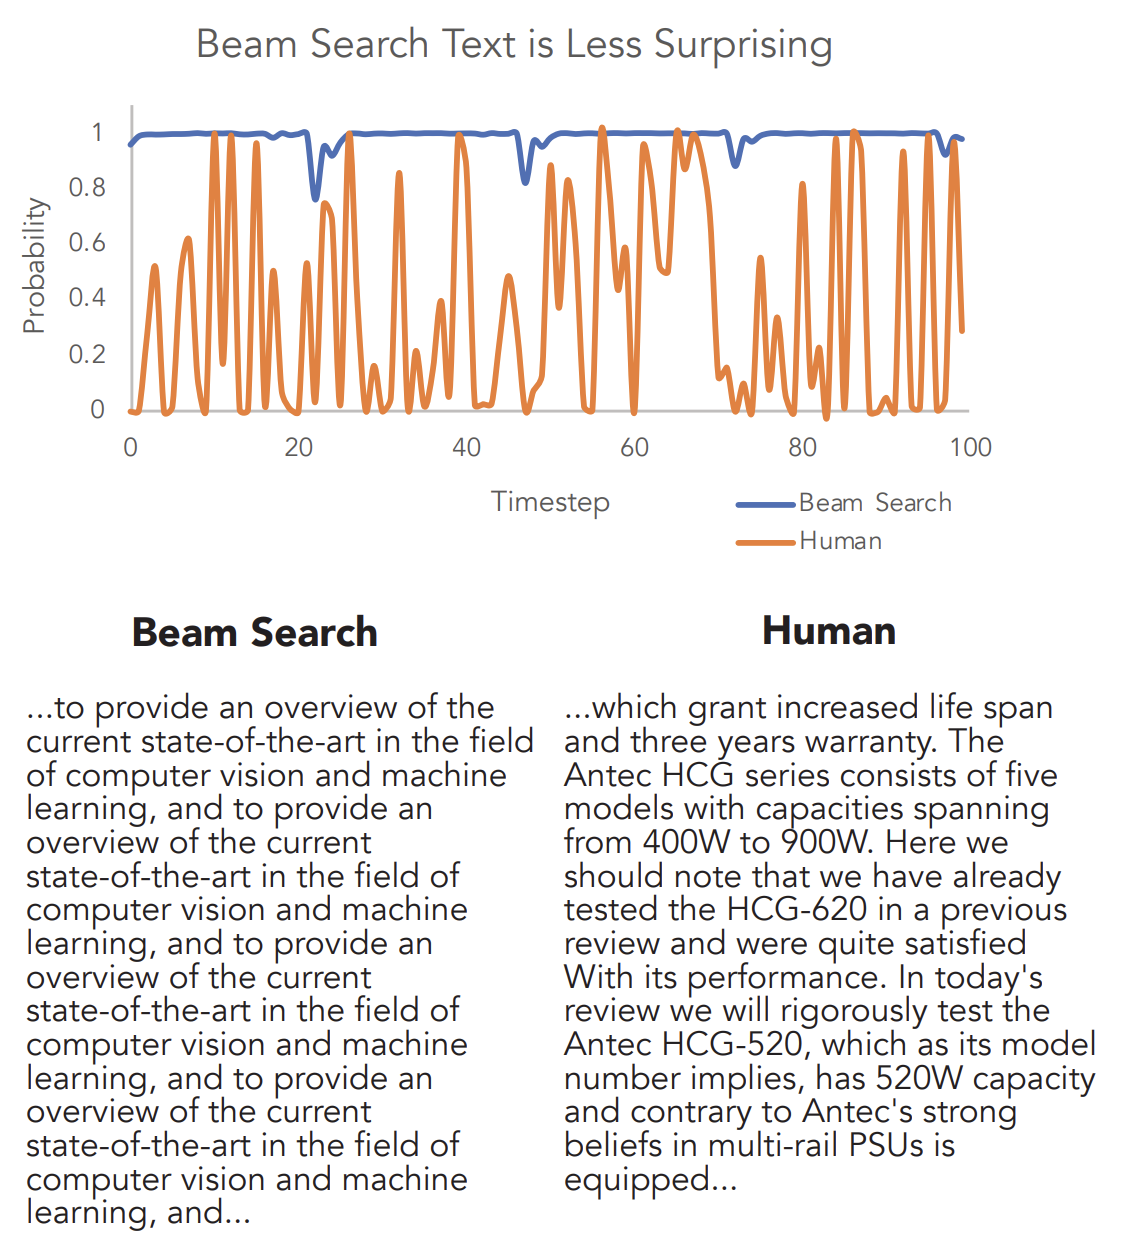
[1] Ari Holtzman, et.al, The Curious Case of Neural Text DeGeneration, ICLR, 2020
For Natural Generation
For Natural Generation
Objective: Generate text similar to human (golden) output
Information:
Motivation:
Adaptively truncate unreliable tail words (see the incoherent gibberish of results of pure sampling);
Better sampling, not just maximize the probability nor pure sampling;
Algorithm:
Choose a set of expected tokens ;
Design a new distribution over tokens;
Algorithms
Algorithms
Top- Sampling:
contains tokens with top- probabilities;
Top-(Nucleus) Sampling:
contains least tokens with summarized probabilities larger than ;
Sampling with Temperature:
, without truncation;
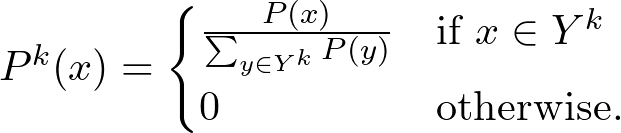
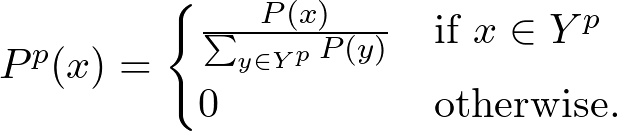
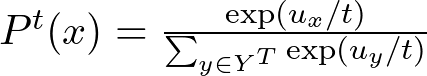
Adaptability
Adaptability
Adaptability is essential when encountering various distributions;
Top-Sampling is most adaptable algorithm;
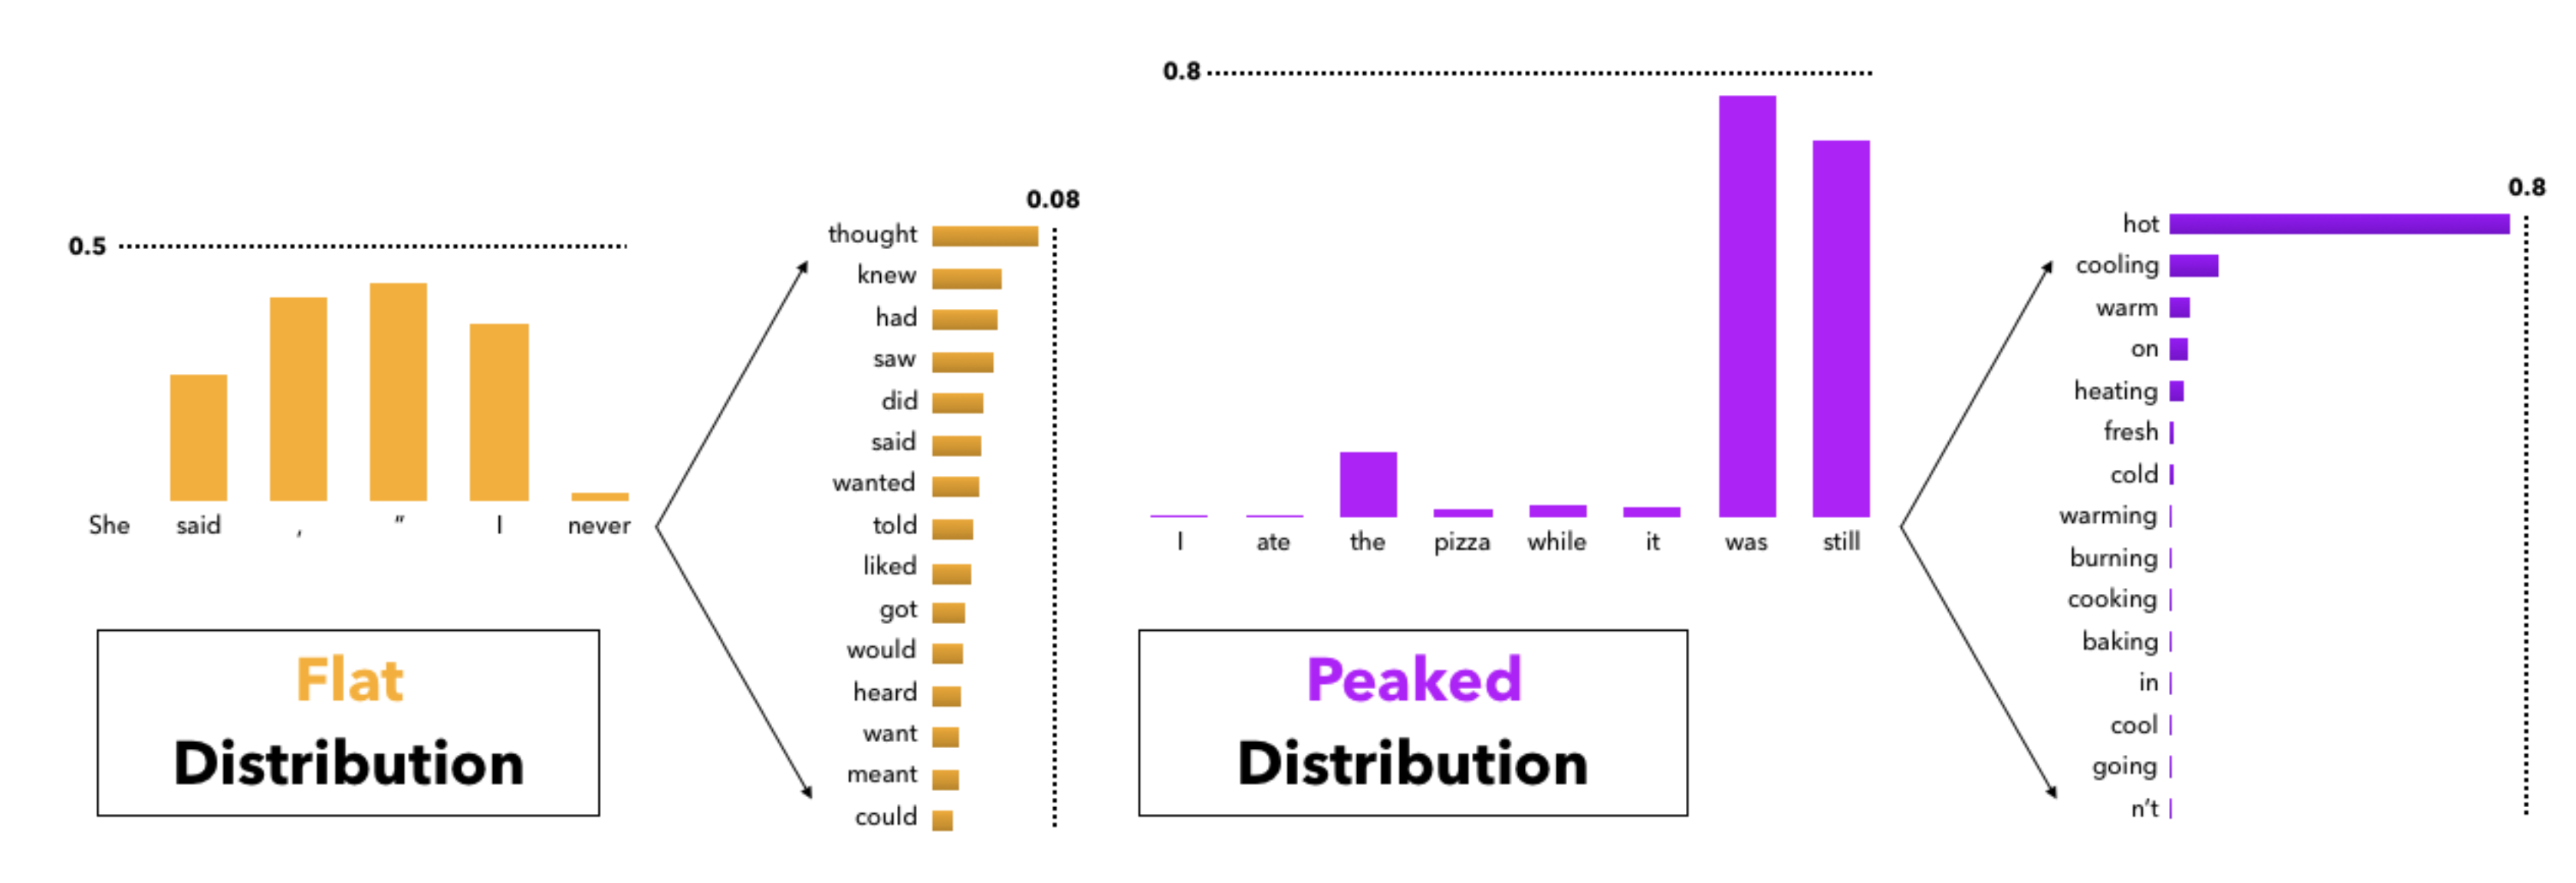
Image Source: Ari Holtzman, et.al, The Curious Case of Neural Text DeGeneration, ICLR, 2020
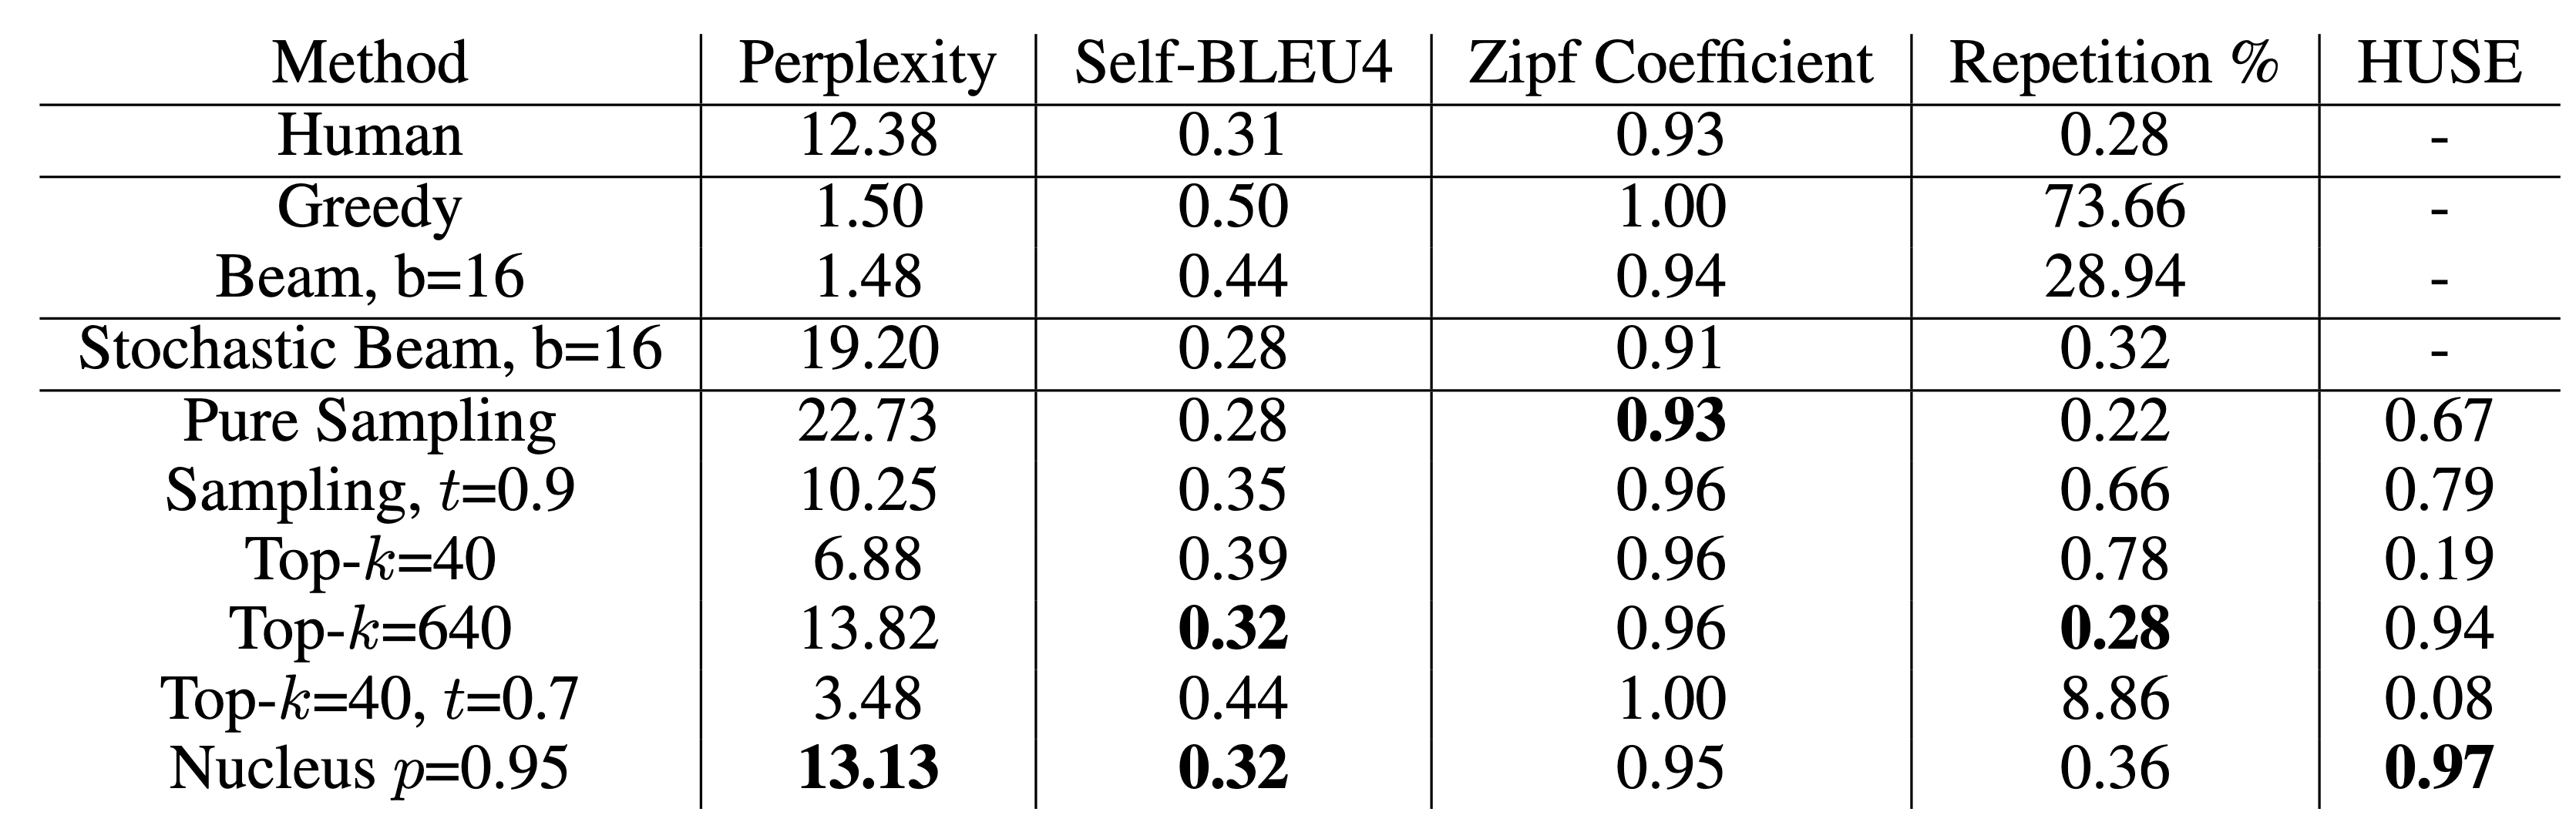
Measure the Similarity with Human Generated Text
Measure the Similarity with Human Generated Text
Features of Generated Texts:
Perplexity: Measure the generation probability; lower means higher probability;
Self-BLEU: Matching score between outputs; lower means higher diversity;
Zipf Coefficient: Parameter of the word frequency distribution;
Repetition: Frequency of finding repeated phrases (at least three times) in output;
HUSE: A unified score of human evaluation and statistical evaluation.
The closer the features of generated texts to those of human generated texts, the better the sampling strategy is.
Evaluation Results
Evaluation Results
Top-Sampling generates texts most similar to human’s;
It is the most popular decoding strategy for LLM;
Their combinations are also used;
Table and Image Source: Ari Holtzman, et.al, The Curious Case of Neural Text DeGeneration, ICLR, 2020
2.5 Large Language Models 2.5.5 Suggested Readings
2.5 Large Language Models 2.5.5 Suggested Readings
Papers
Papers
T. B. Brown, et.al., Language Models are Few-Shot Learners, 2020
J. Kaplan, et.al., Scaling Laws for Neural Language Models, 2020
J. Wei, et.al. Emergent Abilities of Large Language Models, 2022
J. Wei, et.al, Finetuned Language Models Are Zero-Shot Learners, 2022
L. Ouyang, et.al., Training language models to follow instructions with human feedback, 2022
Any Questions?
Any Questions?